想搞懂大语言模型的人,面前通常只有两种材料:一种是论文,讲某一层架构怎么改;一种是新闻,讲哪家又烧了多少亿。卡住的地方是同一个——没有人把从零到 ChatGPT 的整条流水线摆在一起,告诉你每一环到底值多少功夫。
这堂斯坦福公开课干的就是这件事。先把课上最反直觉的一句判断摆在这:学术界把绝大部分精力花在架构和训练算法上,但工业界真正决定成败的是另外三样——数据、评估、系统。讲师说这话有资格:他本人就是 Alpaca 项目的作者之一,那正是用合成数据微调出开源助手的开山之作。整堂课 1 小时 44 分钟,从分词器讲到 7500 万美元的成本账,原始视频由 X 用户 tobarra 分享。本文按录像和 23 张课件截图逐段核过,重排成一道选择题:如果你要在这一行投入精力或预算,预训练和后训练,该押哪一头。
01 预训练在干什么:把互联网压缩成一台「猜下一个词」的机器
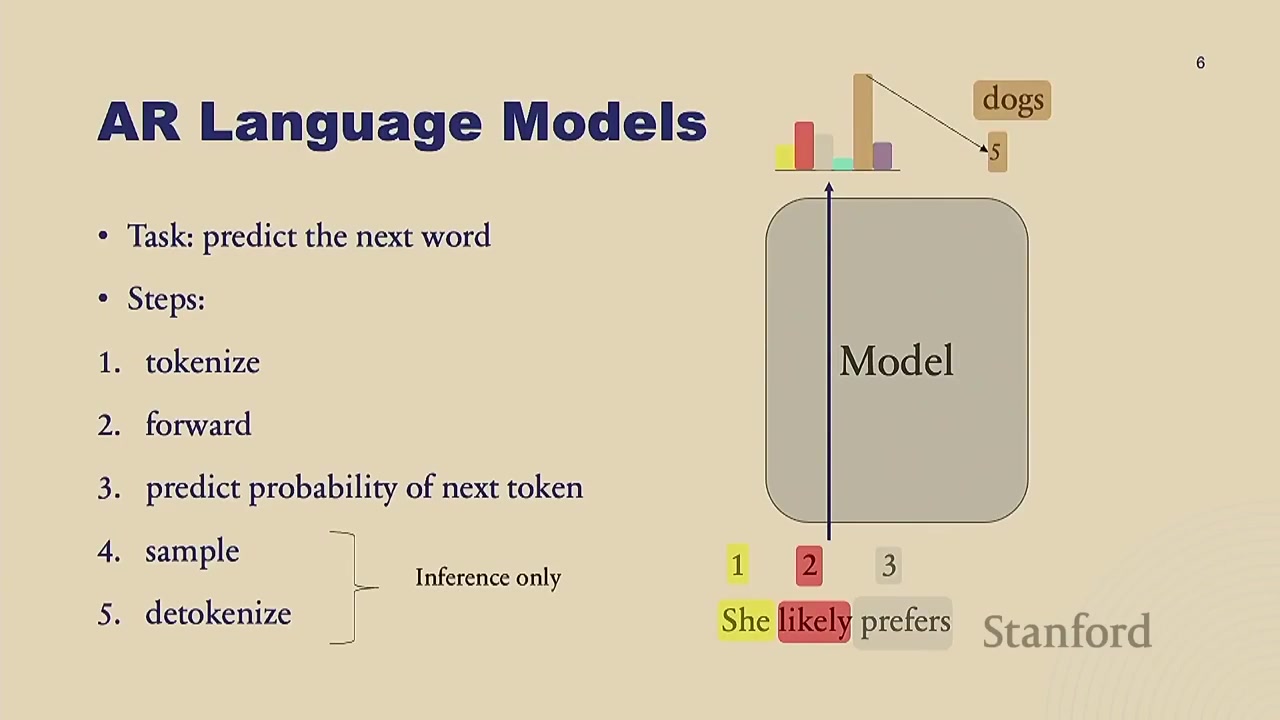
语言模型做的事只有一件:给词序列打分。「老鼠吃了奶酪」的概率应该比「奶酪吃了老鼠」高,因为前者合乎语法和常识。现在主流的做法叫自回归模型——按链式法则把这个概率拆成「逐词条件概率」的乘积,每一步只猜下一个词,没有任何近似。代价是生成时必须一个词一个词往外蹦,句子越长越慢。
完整流程是:文本切成 token,编上号,送进 Transformer,输出一个覆盖整个词表的概率分布,从中采样,再还原成文字。注意词表大小就是模型的输出维度,这也是为什么后面要讲分词器。训练时的损失函数是交叉熵:拉高正确词的概率、压低其他词,数学上等价于最大化整段文本的对数似然——预训练阶段最核心的优化目标,就这一句话。
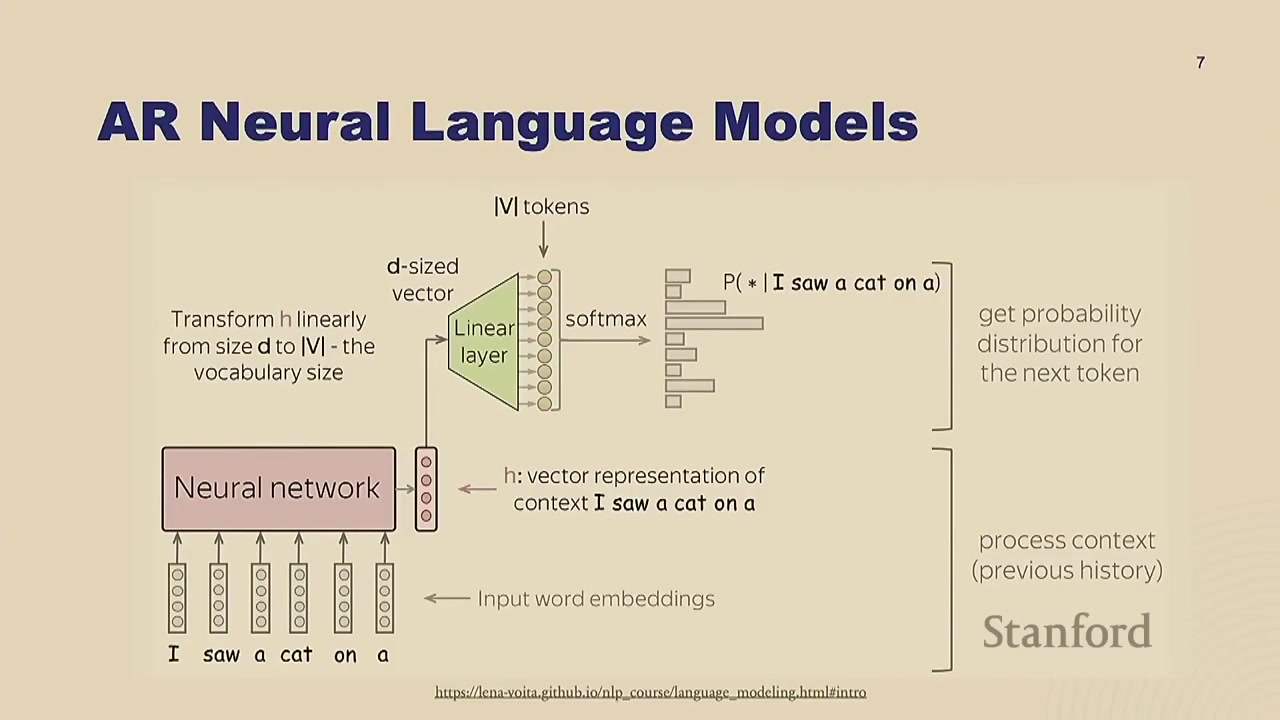
如果看得再深一层,每个 token 先嵌入成向量,过 Transformer 拿到整句的表示,再经线性层映射到词表大小、过 softmax,得到下一个词的分布。
02 分词器:没人讨论,却决定模型会不会数数
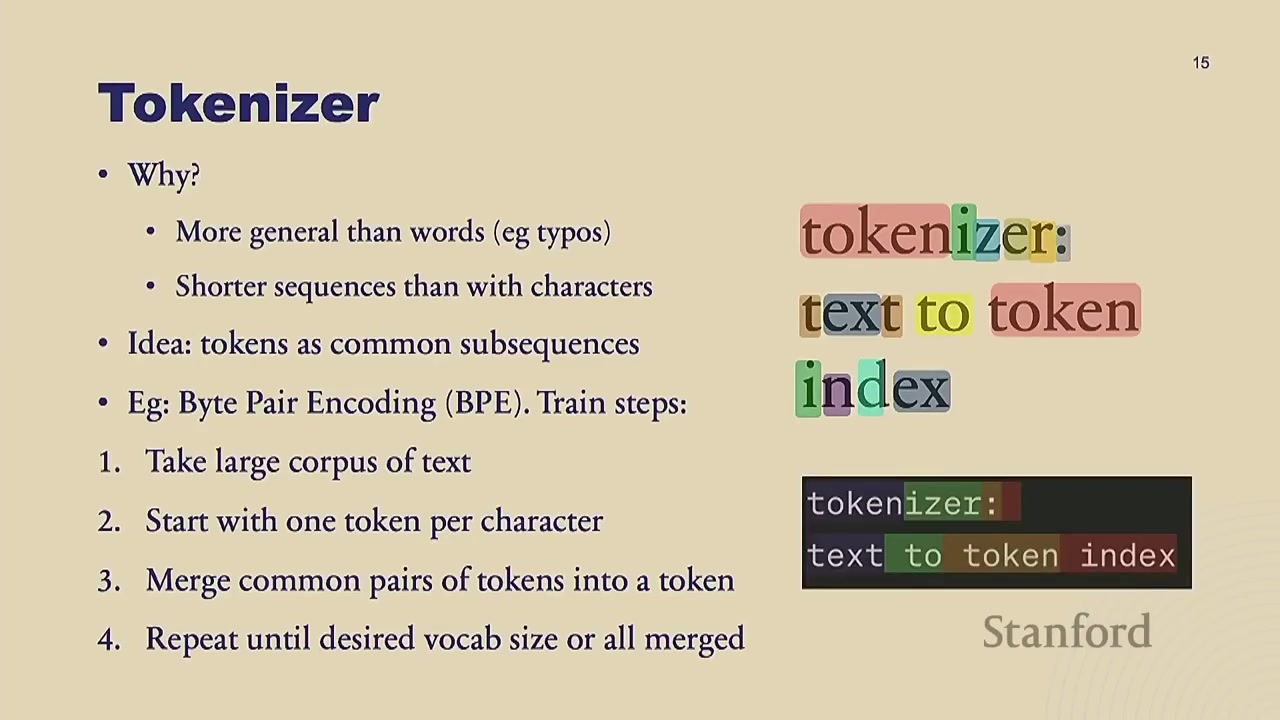
分词器是课上花了相当长篇幅、而外界很少谈的环节。不能按词切——拼写错误没有对应 token,泰语这类语言根本没有空格;也不能按字符切——序列太长,注意力开销随长度平方增长。主流的 BPE 算法在两者之间折中:先在语料上从字符起步,反复合并出现频率最高的相邻 token 对,直到词表达标。平均一个 token 约三到四个字母,「token」是一个整体,「tokenizer」则被拆成「token」加「izer」。
这套机制的缺陷直接影响模型能力。数字至今没有被合理地 token 化:327 可能被当成一个独立 token,模型就无法像人一样逐位组合、进位,数学泛化天然受限。GPT-4 的一项重要改进就是重做了代码的分词方式,此前 Python 行首的四个空格处理得非常别扭,模型因此读不懂代码结构。业内已有人主张干脆抛弃分词器、回到逐字节方案,眼下的拦路虎还是那个平方级的复杂度。
03 数据:从 2500 亿网页里筛出 15 万亿 token,这才是护城河
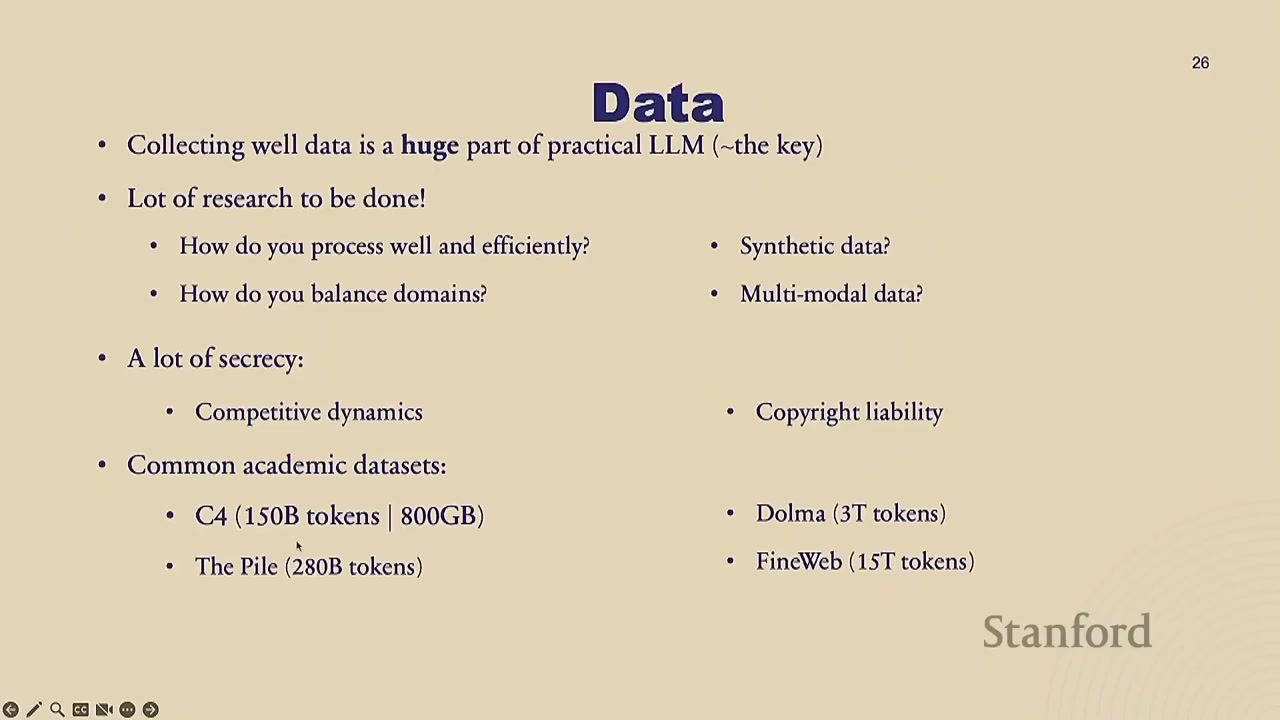
「用整个互联网训练」这句话的工程量远超字面。Common Crawl 收录约 2500 亿网页、超过 1 PB 原始数据,而随机抽一页出来,多半是没写完句子的广告页。从这堆原料到训练数据,要过五关:从 HTML 抽正文(数学公式尤其难抽)、去页眉页脚样板、过滤有害内容和隐私信息、在海量规模上去重、再用启发式规则和分类器筛质量——一个常用的巧招是拿维基百科引用过的外链页面当正样本,训一个分类器去给全网打分。之后还要按领域配权重:代码和书籍上调(代码被经验证明有助于推理),娱乐下调。
投入有多大?课上给的参照是 Llama 团队约 70 人,其中约 15 人做数据;数据工作不需要太多人力,但吃巨量 CPU 算力。规模上,训练数据从早期约 1500 亿 token(约 800 GB)涨到现在的约 15 万亿 token(约 8 万 GB),相当于对原始爬取做了 100 到 1000 倍的过滤——Llama 2 用 2 万亿,Llama 3 用 15 万亿,GPT-4 据泄露信息约 13 万亿。各公司对数据策略讳莫如深,原因有二:商业竞争,以及版权——实际在书籍上训练了,但谁都不会公开承认。
04 Scaling laws:这行里最接近「物理定律」的东西
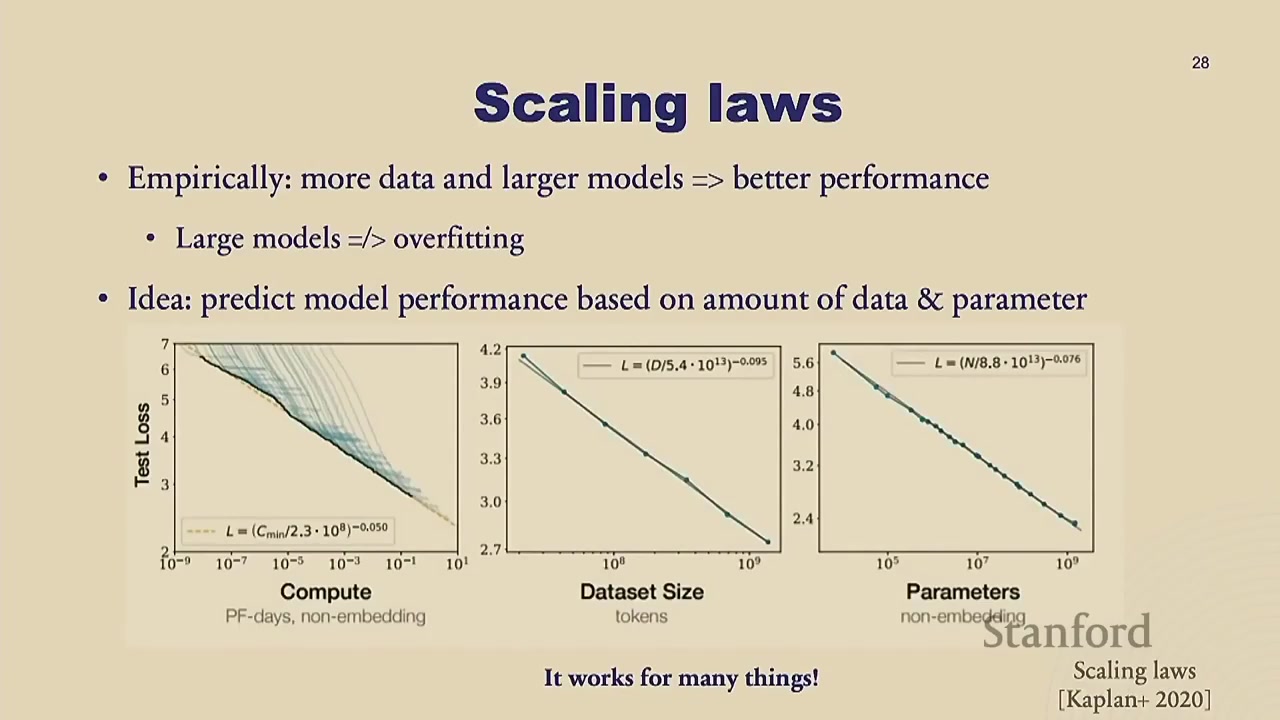
2020 年起被反复验证的经验规律:数据越多、模型越大,损失越低,而且在双对数坐标下是一条直线。这意味着只要知道准备投入多少算力,就能预测两三年后的模型性能——它没有任何理论推导,纯粹是经验,但至今没有放缓的迹象。
它直接改变了一线的工作方式。旧做法是有一万张 GPU 就在大模型上调超参,三十天训三十个模型,最后上线那个其实只训了一天;新做法是先用几天在不同规模的小模型上拟合出扩展曲线,外推到目标规模,再把剩下的二十多天全部押给一次大训练。选架构也靠它:分别拟合 Transformer 和 LSTM 的曲线再外推十倍算力,谁优谁劣一目了然。读这种曲线看两点——斜率和截距。架构上的小改动(换一种激活函数之类)大多只挪动截距,多训十小时或者等下一代 GPU 就抹平了;真正拉开差距的是数据质量,好数据会让整条曲线显著下移。
资源配比也有答案。Chinchilla 论文用等算力曲线扫出最优解:每个参数配约 20 个 token 时训练损失最低;但生产模型要长期跑推理,小模型推理便宜,兼顾之后业界主流配比是每参数约 150 个 token。
拿 Llama-3 405B 算一笔账:4050 亿参数、15.6 万亿 token,算力约 3.8×10²⁵ FLOPs,恰好压在拜登行政令 10²⁶ 的特别审查线以下;一万六千张 H100 跑约 70 天、2600 万 GPU 小时(官方公布约 3000 万),按每小时 2 美元租金下限算是 5200 万美元,再加约 50 人的团队薪酬 2500 万美元,总成本约 7500 万美元,误差上下一千万。而每一代模型的算力需求大约再乘十,瓶颈已经挪到能源和 GPU 供给上。
05 后训练:SFT 让模型「好好说话」,也顺手埋下了幻觉
预训练出来的 GPT-3 不是助手。问它「向六岁小孩解释登月」,它会续写「向六岁小孩解释引力理论」——因为互联网上问题后面跟着的通常是更多问题,而不是答案。后训练要解决的正是这个落差,第一步是监督微调(SFT):拿人写的「问题—理想答案」对,继续做同一个语言建模训练,损失函数和预训练一模一样,只是换了数据、把学习率从接近零重新拉高到 1e-5 的量级。
这一步反直觉的地方在于它便宜得离谱。LIMA 论文把 SFT 数据从 2000 条加到 32000 条,收益微乎其微——扩展定律在这里失效,因为 SFT 不教新知识,只是把模型偏向某一种说话风格,本质是格式化和特化。讲师自己参与的 Alpaca 项目更激进:175 条人工问答做种子,让当时最强的 text-davinci-003 扩写成 52000 条,直接微调 LLaMA-7B,就成了 Alpaca。正是这类工作让 GPT-3 从研究圈走向人人皆知的 ChatGPT。
但 SFT 有一个隐蔽的代价:幻觉。课上给的机制解释很具体——让人类给「买方垄断」写一篇带参考文献的介绍,如果模型预训练时从没见过那本书,你等于在教它「编造一条听起来合理的引用」,而不是输出它真正学过的内容。幻觉可能不是模型学坏了,而是微调方式本身诱导出来的。
06 RLHF 与 DPO:不再模仿人,改为最大化偏好
SFT 的天花板是人的手:人能分辨好坏,未必写得出来最好的答案;而且请人写完整答案太贵。RLHF 换了目标——不克隆人类行为,而是让模型多生成「被偏好的那个」。做法是同一指令生成两个回答,标注员挑一个更好的,再用偏好数据训一个奖励模型(本质是输出连续分数的分类器),最后上 PPO 做强化学习。
PPO 在工程上以难搞著称:rollout、外层循环、梯度裁剪,文档还残缺。于是斯坦福提出了 DPO:跳过强化学习,直接最大化偏好答案的似然、压低不偏好的,一步最大似然收工。在一定假设下两者的全局最优解等价,实测效果相当,DPO 如今已成开源与业界的标准做法。
更值得记的是偏好数据本身的问题。两位标注员看两条都「还行」的自动驾驶回答,多半选更长的那条——所以 RLHF 训得越多,模型越啰嗦,ChatGPT 的话痨正是偏好的累积。这篇论文的五位作者亲自下场标注,事先讨论三小时,二分类任务的自我一致率也只有 66% 到 68%。而 LLM 标注成本约为人工的五十分之一,与人类多数意见的一致率反而更高——人有方差,模型没有,它有一点偏,但稳。这同样已是业界标准。
07 评估:排行榜里的水分比你想的多
预训练看困惑度——模型猜下一个词时「在几个候选之间犹豫」,2017 到 2023 年从约 70 降到不足 10。但困惑度依赖分词器:ChatGPT 词表约一万,Gemini 约十万,上限差了十倍,横向比较直接失真。对齐之后它干脆失效,因为模型不再建模分布,只押单一答案。
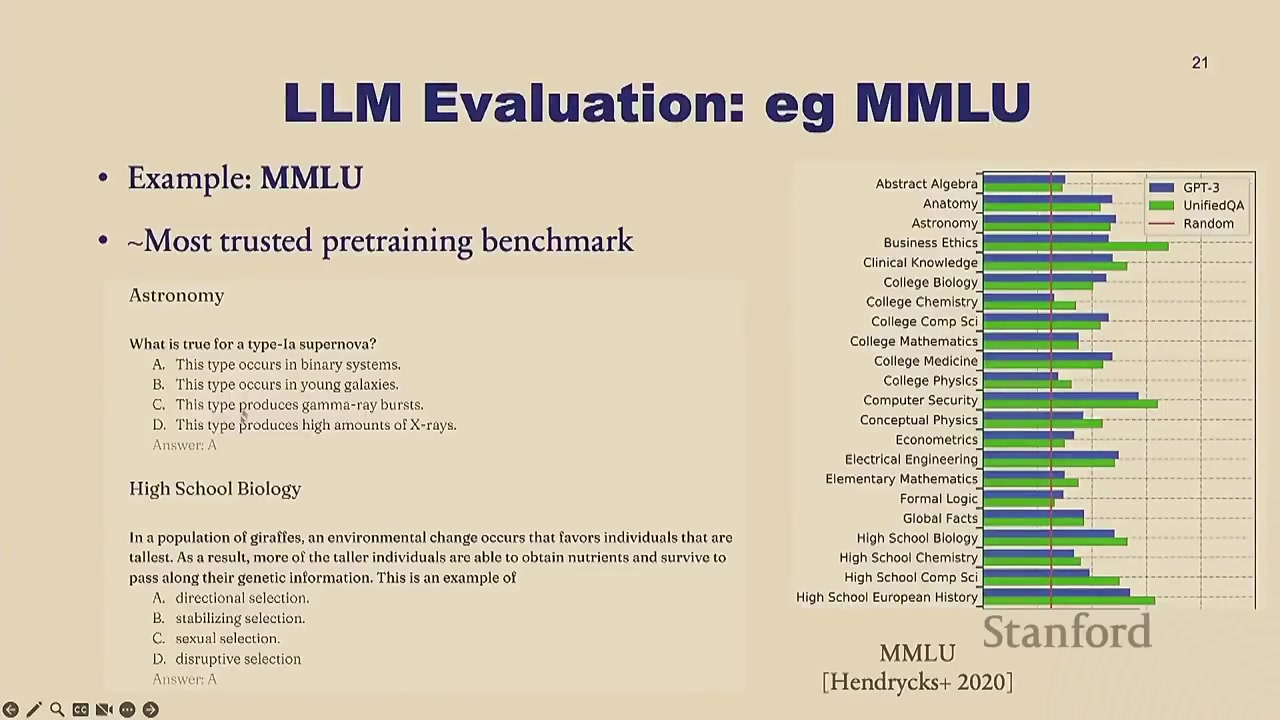
于是学界转向聚合基准,最主流的是斯坦福的 HELM 和 Hugging Face 的 Open LLM Leaderboard,以 MMLU 这类选择题为代表:不让模型自由发挥,只比较 A、B、C、D 四个候选的似然。问题是各家的评测方法并不统一——同一个 LLaMA-65B,在 HELM 上 63.7 分,换一套基准只有 48.8 分,还没算提示词模板的影响。另一个暗坑是测试集污染,检测手法颇为巧妙:多数网络数据集没打乱顺序,让模型分别按原序和乱序生成测试样本,原序概率明显更高,就说明它多半在训练集里见过。
后训练模型的评测更难,目前最受信任的是 Chatbot Arena:真实用户盲评两个匿名模型,攒够几十万偏好后排座次,但用户偏技术向、成本高、速度慢。替代方案是让 GPT-4 当裁判算胜率(AlpacaEval),一次不到三分钟、不到十美元,与 Arena 人类偏好的相关性高达 98%——只是它有明显的长度偏差:同样自我对战,提示「回答详尽」胜率从 50% 跳到 64.4%,提示「简洁」就跌到 20%。课上给的解法是用回归分析把长度变量控制住,控制之后长度的影响大幅缩水。
08 还有一个谁都绕不开的瓶颈:系统
算力是所有人的瓶颈——GPU 又贵又稀缺,攥着一千万美元也买不到顶级卡,多卡之间通信还吃时间。GPU 为高吞吐而生、为矩阵乘法优化,能写成矩阵乘的操作比别的写法快约十倍;麻烦在于算力增速一直跑赢内存和通信,未经优化的代码会让 GPU 大部分时间闲置。衡量指标是 MFU(实际吞吐除以理论峰值),做到 50% 已属优秀,Meta 训 Llama 大约 45%——大厂也喂不饱自己的卡。
两个立即可用的技巧:一是低精度,权重按 32 位存储、计算时转 16 位、更新仍回 32 位,通信和显存都省一半;二是算子融合,别让每行 PyTorch 都把数据搬进搬出显存,对模型调一次 torch.compile,实测提速约两倍。
09 押在哪一头:编者的判断
把整堂课折成决策语言,其实是三条:
做预训练的人,钱该花在数据和系统上,不是架构上。扩展定律已经判了架构微调的死刑——那点儿截距差异十小时就抹平;而数据质量直接挪动整条曲线,系统利用率(45% 对 50%)就是真金白银。Llama 团队五分之一的人在做数据,这个比例本身就是答案。
做产品和应用的人,差异化和幻觉都在后训练这一侧。预训练权重人人能下载,SFT 选什么风格、偏好数据谁来标、裁判的长度偏差控没控,才是体验拉开差距的地方。同时要清醒:SFT 本身可能就是幻觉的来源之一,追求「看起来专业」的回答风格是有代价的。
谁都别拿单一榜单做决策。63.7 和 48.8 是同一个模型,50% 和 64.4% 是同一个模型。看榜之前先问评测方法、有没有控长度、测试集洗没洗过。
最后交代边界:这堂课的视野停在 Llama 3 时代,推理时计算、可验证奖励的强化学习这些后来的范式不在射程内;扩展定律「没人知道何时到平台期」也是讲师的原话。把它当一张 2024 年的地图用,地形没变,但新修的路要自己补。
本文观点出自斯坦福公开课讲师(Alpaca 项目作者之一)的讲授,视频由 X 用户 tobarra 分享。