用大模型 API 写过程序的人,多半停在同一个阶段:一次调用、一段提示词,要模型一口气给出完整结果。想再往前一步——让它自己上网查资料、检查自己的产出、在动真格的操作前停下来等人点头——就得把这些零件拼成一个能循环、能记账、能中断的系统,而这恰恰是各路文档最不讲清楚的部分。Deeplearning.AI 的免费短课《AI Agents in LangGraph》把这条路从头到尾走了一遍:全长 1 小时 52 分,吴恩达(Andrew Ng)主持,LangChain 联合创始人兼 CEO Harrison Chase 与 Tavily 联合创始人兼 CEO Rotem Alaluf 主讲,大量篇幅在现场写代码。
先交代体例:本文是这门课的转述与拆解,配图全部来自课程录像画面,不是编者的实践复盘;两处转写走样(合作方 Tavily 的名字、手写 ReAct 起步代码的作者名)已按画面与公开出处订正。两小时的内容被整理成能直接拿走的东西:5 个设计模式、一张两节点的最小图、3 种人在环模式、1 个完整的写作图系统,外加课程点名但没来得及动手搭的 5 种进阶架构。
01 为什么「一口气写完」必输
课程开场先立论:让模型迭代多轮完成任务,普遍好过让它一次写完全部。吴恩达给的类比是写文章——一次性写法等于不许按退格键,从第一个字写到最后一个字;迭代式写法是先列提纲、缺资料就去联网检索、写完草稿回头批评自己、再按批评意见修改。他补了一句大实话:真让一个人不许回退地从开头写到结尾,连他自己也写不好。
两个延伸值得记。其一,几个人合写一篇论文本来就是这种流程:一人规划拟大纲,一人负责检索整理资料,一人写初稿,写完互相提意见,决定是补检索还是调整内容——把每个角色换成一段提示词加一个语言模型,就是这门课后面要搭的东西。其二,智能体工作流已经在反哺模型训练:让模型带着反思、花更多算力生成的高质量数据,可以拿去训练下一代模型,让下一代用更少的算力达到相近效果;直接生成文本连着自训多代效果并不理想,中间插入工作流产出的数据才有价值。
吴恩达还讲了自己的「智能体时刻」:在斯坦福做现场演示,让 AI 先做网页搜索再写一篇文章,搜索 API 当场调用失败,眼看要翻车,他自己也忘了还给智能体配过维基百科检索这个备选——智能体自己切换到维基百科,取回资料,把文章写完,演示没有中断。他的判断是,未来几个月到几年,很多人会经历自己的智能体时刻:软件能自主完成一串复杂动作,真正替人把事做完。
02 5 个设计模式:先诊断缺哪块,再挑零件
课程把智能体工作流拆成五个设计模式,这也是全文的骨架,表格可以直接搬走:
| 模式 | 干什么 | 什么时候想起它 |
|---|---|---|
| 规划(Planning) | 先想清楚步骤、定下大纲再动手 | 任务路径不明,不知从哪下嘴 |
| 工具使用(Tool use) | 给模型接上工具(如搜索),并让它在合适时机调用 | 要查实时信息、要执行真实动作 |
| 反思(Reflection) | 对自己的产出提批评并迭代改进,也可多个模型互评形成编辑循环 | 产出要多稿打磨 |
| 多代理协作(Multi-agent) | 多个模型各扮一个角色(研究员、编辑),各有独立提示词 | 一段提示词装不下多种职责 |
| 记忆(Memory) | 跨步骤跟踪进展与结果 | 流程长于一步、要接续上文 |
课程同时提醒一句:这五样里只有一部分能力长在模型身上(比如供工具调用用的函数调用能力),更多的能力由模型外面的框架实现——这正是 LangChain 和 LangGraph 的位置。
03 手写 ReAct:不靠框架,看清一个 Agent 的全部家当
课程写第一行 LangGraph 代码之前,先做了一件更值钱的事:只用 OpenAI 的接口加少量 Python,从零手写一个最小的 ReAct 智能体(ReAct 即 Reasoning 加 Acting,推理加行动)。目的不是造轮子,而是看清哪些职责归模型、哪些归围绕模型的代码。课程把这圈代码叫运行时(runtime)。
它的家当分三层。模型层:初始化 OpenAI 客户端,用 GPT-4,temperature(采样温度)设为零,换取高度确定的输出。提示词层:系统提示词要求模型按「Thought(描述思路)→ Action(调用某个工具)→ Pause(本轮动作已发出)→ Observation(工具结果回传)」循环,做完再输出 Answer;提示词里还带一条完整的示例轨迹,课程强调这段示例对模型学会玩法非常关键。工具层只给两个玩具:calculate,把传入的字符串直接当表达式求值;average dog weight,一个预设了苏格兰梗、边境牧羊犬、玩具贵宾犬体重的模拟查询。起步代码取自 Simon Willison 那篇手写入门博客。
先手动跑一遍找感觉。问「一只玩具贵宾犬有多重」,模型回一段思考加动作加暂停,指示调用 average dog weight;执行后把观察结果格式化进下一轮提示再问,模型给出答案:7 磅。再上强度,问「一只边境牧羊犬加一只苏格兰梗,合计多重」。模型的计划相当合理——先分别查两种犬的体重,再相加。它先查边境牧羊犬,拿到 37 磅;再查苏格兰梗,拿到 20 磅;最后调用 calculate 算 37 加 20,输出 57 磅。验证方式也现成:智能体内部的消息数组留了全痕,系统提示、问题、动作指示、观察、最终回答,一条不缺。
手动跑通后装进循环:query 函数接收问题和一个 max turns 上限,每轮用正则表达式从模型响应里解析动作——解析得到动作就查字典执行,动作不在已知字典里则抛异常,把观察结果拼成下一轮提示;解析不到动作,说明模型给了最终答案,返回并结束。课程的原话是,到这里你拥有了一个具备工具调用能力的智能体,而它只用了原始模型接口和一点 Python。
04 LangChain 的零件铺:提示词模板和 Hub
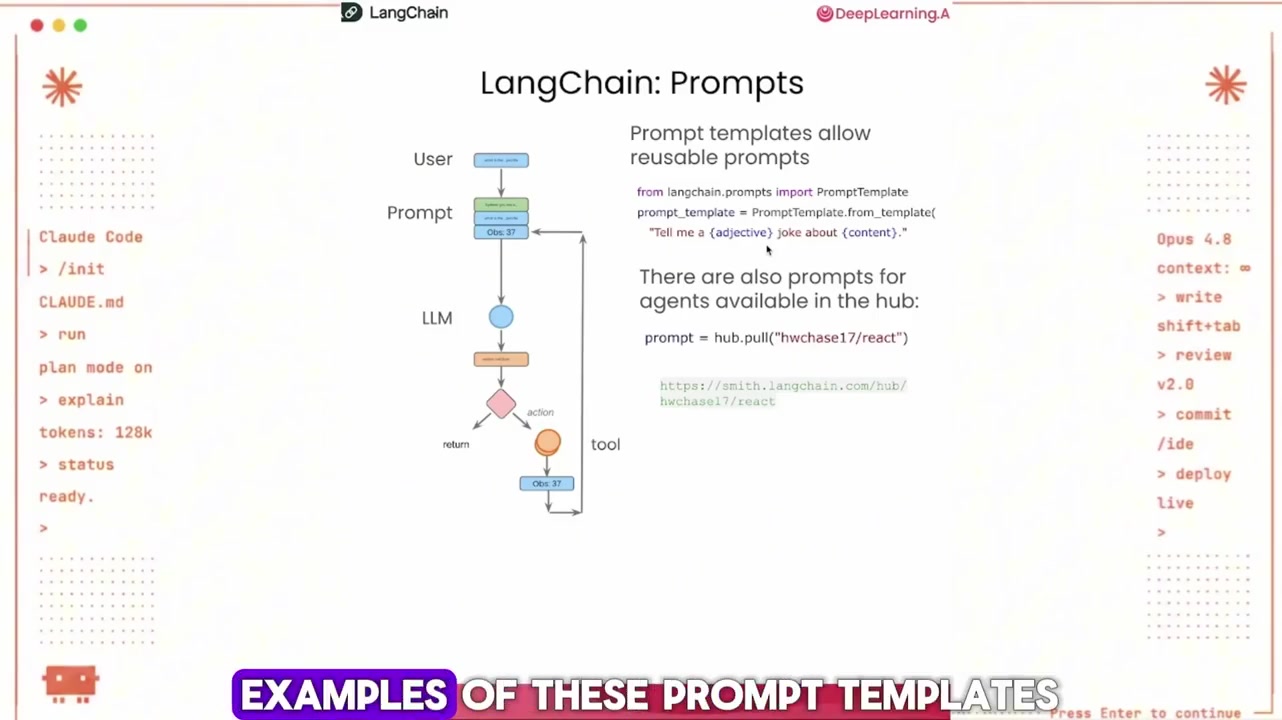
第二遍搭同一个智能体,改用框架。LangChain 先贡献两样零件。提示词模板(Prompt Template)本质是带格式化变量的字符串,幻灯片上的示例模板串是「Tell me a {adjective} joke about {content}」,同一份模板按用户输入格式化出不同提示;接着的代码直接从 Hub 拉了 hwchase17/react 这份现成的 ReAct 模板。Hub 模板的关键设计与手写版一致:不把工具硬编码进提示词,工具和工具名用变量占位,另传入用户问题和 agent scratchpad(草稿区,记录智能体已做过的全部动作与观察),换工具不用改模板。
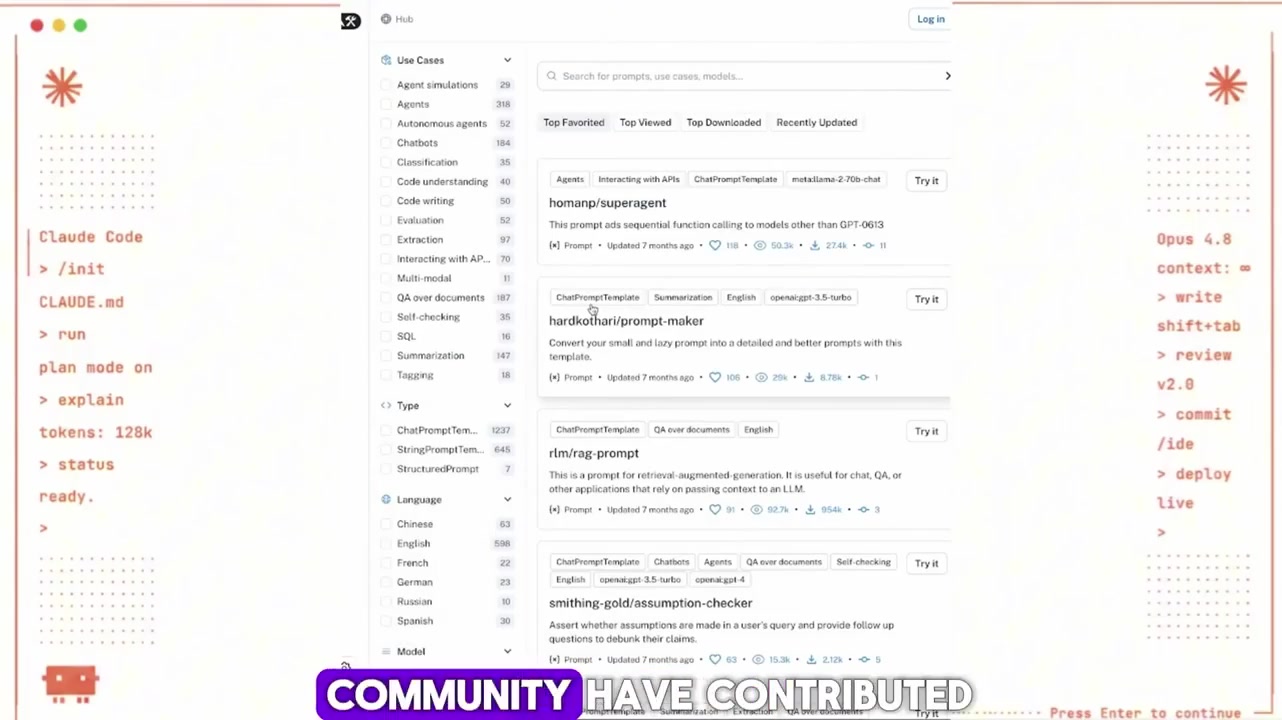
Hub 是社区共享提示词的地方,课程截图时点光 Agents 一个分类就有 318 份模板,文档问答 187 份、摘要 147 份。工具这边,langchain_community 包里装着数百个现成工具,课上演示导入的就是 Tavily 搜索——这也是贯穿全课的搜索工具。
05 LangGraph 三件套:把最难写的循环画成图
课程点破一个观察:此前智能体实现里代码量最大、最核心的部分,就是那个控制循环的函数。LangGraph 的主张是把这段控制流从代码里拿出来,描述成一张图。它支持循环图(cyclic graphs),天然贴合「决策—执行—再决策」的往复;幻灯片把它的独有能力列成三条:循环图、持久化、人在环。
三件套:Nodes(节点)是智能体或函数,负责干活;Edges(边)连接节点,规定数据流向;Conditional Edges(条件边)决定下一跳去哪,让图能按状态分支。
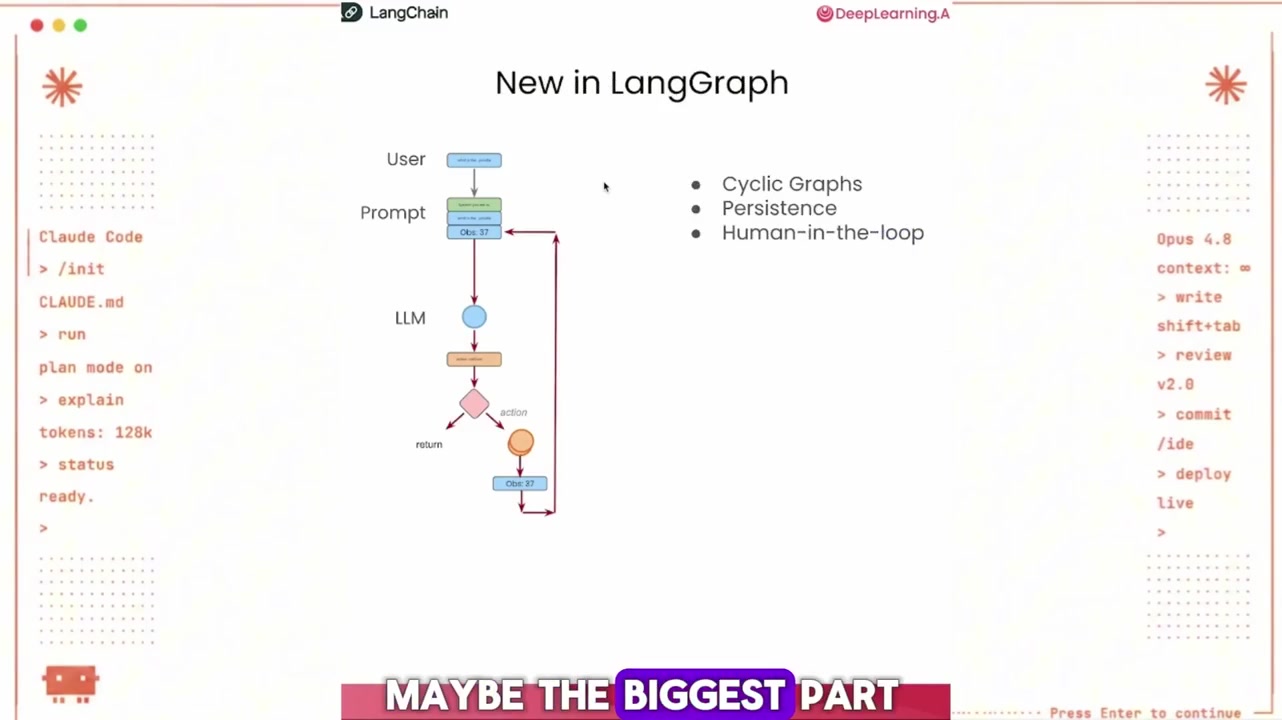
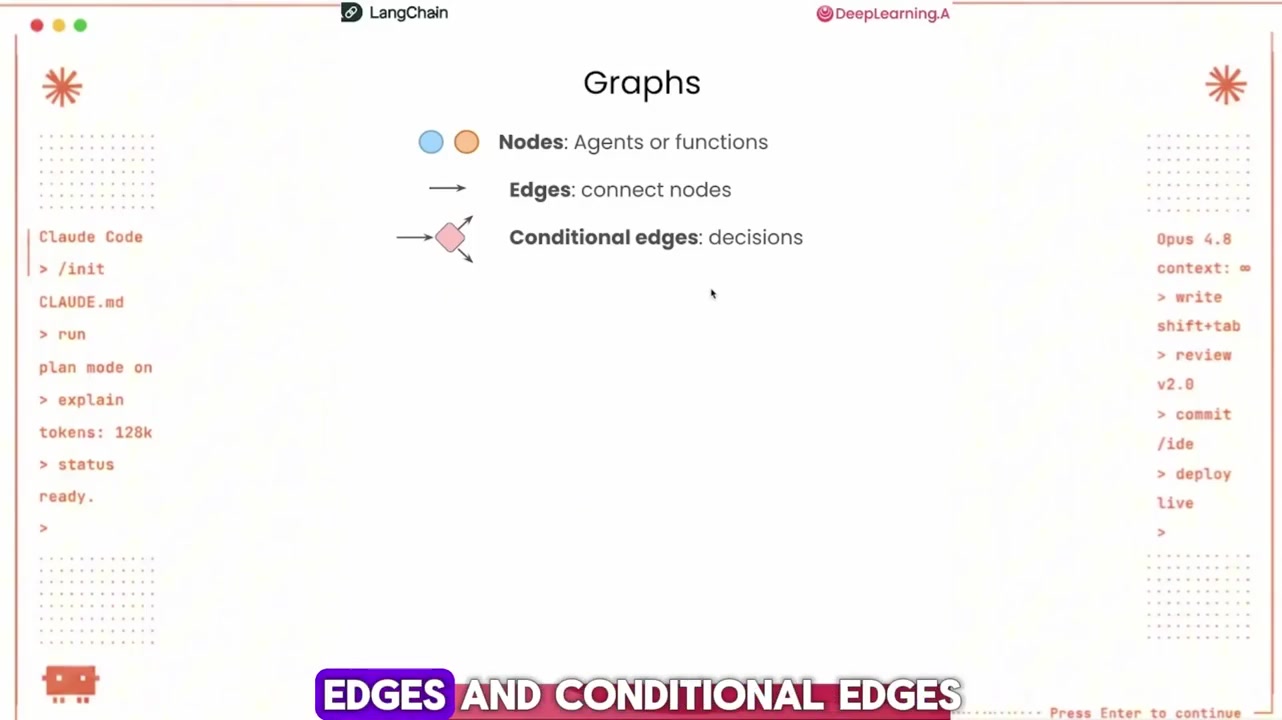
最小的一张 Agent 图长这样:一个 llm 节点负责调用模型;跟在后面的条件边判断模型输出里有没有 tool_calls(工具调用列表)——有就进 action 节点执行工具,没有就走向 END 结束;再补一条 action 指回 llm 的普通边,把工具结果送回模型。入口设在 llm。图建好调用 compile 编译成 LangChain Runnable(统一调用接口的对象),再调 get_graph 的 draw_ascii 或 draw_png,就能自动打印出这张图看结构。
设计哲学压轴:受控。节点之间由明确箭头连接,决策路径在图上看得见。课程认为这种可控性是做出好用智能体的关键,也是 LangGraph 与其他框架的分水岭——它是专为智能体和多智能体流程而生的 LangChain 扩展。
06 Agent state:随时间追踪的那本账
理解 LangGraph 最要紧的一件事是状态(state):图的每个节点、每条边都能访问它,它只作用于当前图内部,又可以存进持久层,随时把流程恢复到任意时间点。最简单的状态就是一个消息列表,关键字段用 operator.add 注解之后,新消息追加进状态,而不是覆盖旧消息。
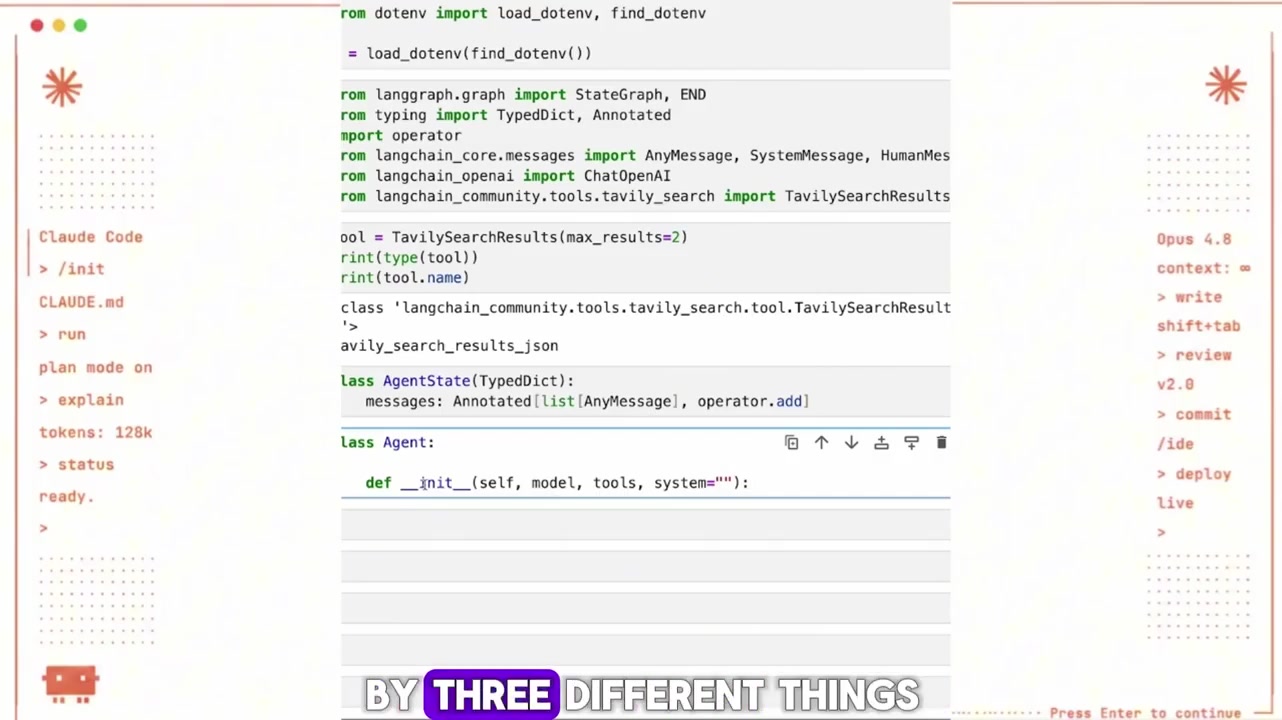
课上把工具、状态、类三样一次配齐:用 TavilySearchResults(max_results=2) 初始化搜索工具,每次最多返回两条结果,模型调用它时用的名字是 tavily_search_results_json;AgentState 定义为带注解的消息列表;Agent 类接收三个参数——模型、工具列表、系统提示词。给模型绑工具用 bind_tools 方法,作用就是让模型知道有哪些工具可调。
07 并行还是串行:一个判断口诀
tool_calls 是个列表,也就是说很多新模型支持一轮里并行发起多个工具调用。课程用两问画出分界。问「旧金山和洛杉矶的天气分别如何」,模型同一轮连发两次 Tavily 查询,两个问题互不依赖,这是并行。问「2024 年超级碗冠军是谁?该队所在州的 GDP 是多少」,模型先查「2024 Super Bowl winner」,拿到堪萨斯城酋长队之后,才发起第二个查询「GDP of Missouri 2023」,查到密苏里州当年第三季度四千多亿美元的数——第二次查询的措辞依赖第一次的结果,必须先回传模型再出发,这是串行。口诀一句话:两次调用互不依赖就走并行,后一次要用前一次的结果就走串行。
08 Agent 为什么要专用搜索:一条 5 步管线
先说为什么不能拿普通搜索凑合:模型的静态权重答不了「昨晚比赛比分」这类动态问题;带来源的结果能压低幻觉、顺滑人机交互。课程把一个搜索工具的内部拆成五步:把问题拆成子问题,应对多意图查询;为每个子问题从多个集成里挑最佳数据源,问天气就走天气接口;从来源里只抽取与子问题直接相关的内容;基础做法是对来源分块后跑一次向量检索,取回最相关的前 K 段;最后给各来源的结果打分,滤掉低相关的。
三种搜索的对比很直观。普通搜索(课上用的 DuckDuckGo)只返回一批链接,还得再写函数抓第一个页面、用 Beautiful Soup(一个网页解析库)解析 HTML、抽标题正文,洗完仍旧冗长。Agent 搜索(Tavily)直接回结构化 JSON,温度湿度风力字段齐全——不是人类想直接看的样子,但正是智能体要的。再对照 Google 的样本页:人类要的是一屏直观的关键信息。同一次查询,三种受众,三种格式。
09 Checkpointer 与 thread:上生产的两件标配
长任务两大件:持久化(persistence),把某时刻的状态存下来、之后回来接着跑;流式(streaming),执行中实时报告进展。LangGraph 用 checkpointer(检查点)落实前者,在每个节点执行之后以及节点之间对状态拍快照。课上先用内置 SqliteSaver 的内存数据库,刷新即清空,换 Redis、Postgres 等外部实现也是现成的。
多会话靠 thread config 区分:一个带 thread_id 的配置字典,生产环境多用户必备。课程的三连问最有说服力:同一条线程先问旧金山天气,模型调 Tavily 作答;追问「LA 呢」——这句话没提天气二字,模型靠检查点里的历史正确理解为问洛杉矶天气;再问「which is warmer」,模型结合完整历史答出洛杉矶目前更暖。把 thread_id 换成新值再问同一句,模型立刻失忆,反问「请说明你要比较的是哪两个对象」。
10 流式的两级:消息级与 token 级
调用从 invoke 换成 stream,返回的就是事件流:旧金山那一问依次吐出三条——AI 决定调 Tavily 的消息、搜索结果的工具消息、最终 AI 回复,中间步骤全部可见。想逐 token(词元)流式输出,用对象内置的 astream_events 异步方法,把检查点换成 AsyncSqliteSaver 解锁异步,然后筛出 on_chat_model_stream 类型的事件逐个取内容。一个容易忽略的细节:函数调用阶段没有内容可流,进入最终回答后 token 才逐个流出。
11 3 种人在环:审批、回溯、写回
人工介入的第一步是换账本规则:operator.add 只会追加,人在环场景有时要替换消息,所以写一个自定义的归并函数——新消息与已有消息同 ID 就替换,否则追加。在此基础上,课程总结了三种模式。
第一种,节点前打断审批。编译图时在 checkpointer 之外再传 interrupt_before(节点执行前中断),值设成 action,任何工具执行前先停。停住后用 get_state 能看到 next 参数指向 action;人工点头后,用同一线程配置再调 stream、输入传 None,流程从断点继续。只想在特定工具前打断的话,文档另有章节。
第二种,回到过去。图执行的每一步都存快照,getStateHistory 返回全部快照的迭代器,每份快照有唯一标识 thread_ts;拿它当起点再执行,就是时间回溯。只传 thread_id 不传 thread_ts,就从当前状态继续。
第三种,改完写回。update_state 把修改后的状态写回当前槽位,后续执行以此为起点。课程的完整演示:先问洛杉矶天气,把状态里那次工具调用的参数从「current weather in Los Angeles」改成「current weather in Louisiana」,写回后流程真的去查了路易斯安那,回报晴天。更进阶两种玩法:在历史状态上改出分支,比如指定改查 AccuWeather;或者伪造一条工具消息,内容填「54 degrees Celsius」,更新时声明 as_node="action"(以动作节点的身份更新),图便跳过真实工具调用,模型直接把假结果写进最终回答。三种模式合起来一句话:能拦、能回、能改。
12 Essay Writer:把全部件装进 1 张图
收官项目是一个写作智能体,四个节点转成一个圈:Plan 一次性生成提纲;Research 按提纲调 Tavily 取回文档;Generate 依提纲加文档写稿;Reflect 对稿子生成批评意见,再按批评意见做第二轮检索,新文档累加进旧文档,回到 Generate 重写。转不转下一轮,由修订计数器决定。
它的状态比消息列表复杂得多,七个字段照抄:
| 字段 | 存什么 |
|---|---|
| task | 人类输入,即论文主题 |
| plan | 规划节点生成的提纲 |
| draft | 当前草稿 |
| critique | 评审意见 |
| content | Tavily 返回的文档列表,只累加 |
| revision_number | 已完成的修订轮数 |
| max_revisions | 允许的最大修订轮数 |
模型侧一共五份提示词:规划、写作、反思、按提纲出检索词、按批评意见出检索词——最后一份与前一份的差别只在输入是批评意见而非提纲。为了逼模型稳定返回字符串列表,用函数调用加 Pydantic(Python 的数据校验库)做结构化输出。实测任务问「LangChain 与 LangSmith 的区别」,课程提到所用模型大概率不了解这两个产品,正好逼它去检索:第一稿标题是 Unveiling the Distinctions: LangChain vs LangSmith,批评意见说概述清晰、建议深挖两者的优缺点;第二轮修订后收尾,成文覆盖定义、可扩展性、可中断性与性能。当时的轮数上限设为 2。
13 带界面跑一遍:每一步都能停、能改、能回退
课程给写作智能体配了个小界面,输入主题点按钮就启动图。编译时设置了 interrupt_after(节点执行后暂停),每个状态跑完都停一下,由界面上的勾选框决定继续还是中止;State Snapshots 标签页展示当前完整记忆——初始状态、当前节点、各字段的值,一目了然。
演示里最生动的一幕:流程停在规划节点,已有一份关于披萨店的提纲,讲者当场把 plan 字段改成「讨论果冻甜甜圈在披萨制作中的重要性」,点修改触发 update_state,再点继续,模型就沿着这条被改过的提纲一本正经写起草稿。不满意还能整体回退:把快照里选中的那条历史状态重新压回记忆栈,等于回到过去重跑;换主题就开新线程——界面里 thread 0 是披萨店、thread 1 是新英格兰 IPA,随时切换。完整代码在 helper.py,课程明说可以直接当项目模板。
14 课程没来得及搭的 5 种架构
结课前的快览,五个值得知道的方向。多代理共享状态:多个智能体操作同一份共享状态,每个可以只是提示词加模型,也可以带工具、内部再嵌自己的循环,要点是状态在智能体之间传递、共同维护。supervisor(监管者)架构:一个监管者负责决定传给每个子代理的输入,子代理各持自己的状态;能力强的模型当监管者效果更好,因为监督和规划本身就吃智能。流工程(flow engineering):出自 AlphaCodium 论文,一条流水线在关键节点带循环——初始方案生成一圈、公开测试迭代一圈、AI 测试再一圈,前段高度单向、到某点转迭代;这是为特定编码任务定制的,但概念可以推广成一句「为智能体的行动与思考设计正确的信息流」。先规划再执行:开头做一次明确规划,交给子代理逐步执行,每步回来视情况更新规划,没完成就重新规划,全部完成再把结果交给用户。语言代理树搜索(LATS):在可能动作的状态之上建一棵搜索树,生成、反思、向下展开子动作,再决定在树的哪一处回溯,把新信息反向传播给父节点、影响后续方向——课程特别点了一句,这套玩法全靠持久化撑着,因为系统必须能回到先前状态。
资源清单一并带走:LangChain 文档(核心包加社区包)、LangServe(把应用一键部署成 Web 服务)、LangSmith(调试、监控、生产、playground)、LangChain 与 LangGraph 两个 GitHub 仓库(cookbook、模板、参考文档与教程)、先修课《Functions, Tools, and Agents with LangChain》、Prompt Hub(借专家提示词找灵感)。
15 编者收束:最值得抄的三样,和边界
编者判断,这门课最值得拿走的是三样。一张两节点的最小图:llm 加 action 加一条条件边,几乎所有智能体循环都从这副骨架起步。一本状态账:state 加 checkpointer 的组合,让调试、多会话、断点恢复、时间旅行全长在同一套机制上。两个中断参数:interrupt_before 与 interrupt_after 把「人」插进图的任意位置,审批和暂停都只是一行配置。
边界也要摆明。课程是录像时点的接口快照,函数名与参数随版本演进很快,素材转写里同一处就有 draw_png 与 mermaid_png 两种记法,本文按口述实录采信前者;落地请以 LangGraph 官方文档和 helper.py 为准。本文是转述整理,代码未逐行复跑,数字与专名以课程素材为准。要启动按三步走:先手写一遍 ReAct 的 query 循环,体会模型与运行时怎么分工;再用两节点的图把同一个智能体重搭一遍,打印出图看结构;最后给 action 节点加上 interrupt_before,体验一次人工审批。走完这三步,这门课的东西才算真的到了手上。
原作者:Andrew Ng(吴恩达,Deeplearning.AI)与 Harrison Chase(LangChain 联合创始人兼 CEO)、Rotem Alaluf(Tavily 联合创始人兼 CEO);本文观点出自 Deeplearning.AI 课程《AI Agents in LangGraph》(1 小时 52 分,LangChain 与 Tavily 合作出品),视频由 X 账号 @AYi_AInotes 转写整理发布。