每天在用 ChatGPT、Claude、Gemini 的人,多半都处在同一类困惑:模型一会儿聪明一会儿胡言;同一个问题扔给不同应用得到的答案差异巨大;想让它干点"高级的活"——读论文、写代码、生成播客——却不知道从哪条工具切入。Andrej Karpathy 在一场约两小时的免费讲座里把这件事从头讲了一遍,覆盖从 token 流的本质、思考模型的工作方式、联网与 Deep Research、Python 解释器、Vibe Coding,到多模态与自定义 GPT 的全链路。
这场讲座的主讲是 Karpathy,他曾在 OpenAI 与 Tesla 各工作四年,是早期把 transformer 搬进大模型工业化的那批人之一;视频原帖由 X 账号 shobhanai(@HeyShobhan)发布。讲座本身被设计成"日常使用者"视角——不假设你是研究员,但要求你愿意把自己当模型的合作者而不是用户。全文按讲座的脉络走完 10 章节:zip 文件心智模型、模型选型与档位、思考模型、联网搜索、Deep Research、读论文与 Python、Artifacts 与 Vibe Coding、多模态、记忆与自定义 GPT——每节对应一类可独立查用的任务。
先交代体例:本文转述自这场约两小时的讲座(视频全长 2 小时 9 分 6 秒),视频原帖由 X 账号 shobhanai(@HeyShobhan)发布;配图全部来自讲座视频画面——讲者的白板示意图、ChatGPT/Claude/Perplexity/Grok 的实机界面、代码与论文示例,画面里所有数字、订阅价格、思考气泡、模型名都以讲者实操为准,不是编者的复盘。全文按讲座的 10 个章节顺序走,每节末尾点明操作建议。
01 把 LLM 想象成一个「1TB 的有损压缩 zip 文件」
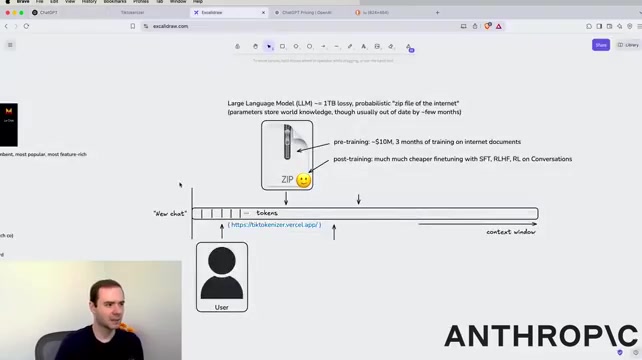
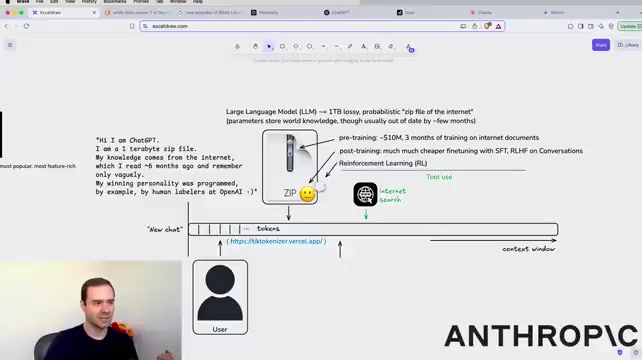
讲座的第一章给出一个贯穿始终的心智模型:你正在与之对话的那个对象,本质是一个大小约 1TB 的有损压缩文件,装着互联网的模糊印象。Karpathy 在白板上画了一张图——一个标着「ZIP」的小图标,连着预训练($10M、三个月互联网文档)和后训练(SFT、RLHF、RL on Conversations)两条线,下面挂着一个 User 与一串 token 流。
预训练阶段的成本极高,常常达数千万美元、训练三个月左右,所以不可能频繁重做。GPT-4o 的训练数据可能截止在数月甚至一年前,模型因此存在知识截止日期(任何比截止日更新的事件都不会出现在参数里),必须借助工具(如联网搜索)才能让模型"看到"。
那么,什么时候可以信任模型的直接回答?Karpathy 给的四条判断依次是:① 知识是否冷门或近期才更新;② 是否是互联网高频出现的内容;③ 能否通过一手资料核对;④ 是否是高风险场景。他自己的两个例子——一杯美式咖啡约 63 mg 咖啡因、感冒时对照 NyQuil 成分——都属于"既不太新、互联网又反复讨论"的常识型问答,模型直接作答可信度较高。NyQuil 的成分他专门翻了包装盒做交叉验证,确认模型这次给的答案确实正确。
与之配套的另一条习惯是把上下文窗口当作稀缺资源:往里塞无关 token 会分散模型注意力、降低准确率、增加推理开销,所以建议保持精炼、切换话题就开新对话。白板图底部那条「"New chat" → tokens」的图示,就是这张图配套出现的第二条信息。
02 模型选型:先看清自己在用哪一档
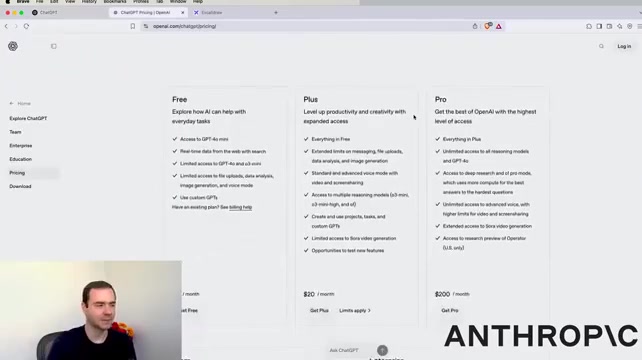
理解了模型本质之后,第二件事是意识到自己当前在用的到底是哪个模型。Karpathy 在 ChatGPT 演示里提醒:左上角下拉菜单里显示的是 GPT-4o;但未登录时 OpenAI 不会告诉你背后调的是哪个,可能是一个更小、更弱、更易幻觉的版本。
三档订阅对应三类使用场景:
- 免费档:GPT-4o mini,更小、更弱、易出错;写入价格表中的"limited access"实际体验无法判断。
- Plus 20 美元/月:每 3 小时约 80 条 GPT-4o,是多数人工作日的实用门槛。
- Pro 200 美元/月:无限 GPT-4o,外加 Deep Research、O1 Pro 等额外权益。
Karpathy 自己订阅了 Pro,理由很直接:"我工作里要写代码,比起省下的 200 美元,换来顶尖模型值得。"(I'm on Pro because I write code for a living and 200 dollars is way less than a coding mistake costs me.)但他同样提示:各家的模型选择器不一样——Anthropic 的 Claude、Gemini、Grok 都有不同的档位划分——按需试验即可,不必押注单家。
他个人最常用的"投票"做法是把同一个问题同时抛给多家模型,看谁答得更好,他把这种做法叫 LLM Council(语言模型议会)。尤其在需要做决策时("去哪度假"这类主观题),把候选答案横向比较往往比单点最佳更可靠。
03 思考模型:让模型在回答前先想一遍
训练 LLM 的第三阶段是强化学习(RL 这一阶段,模型会在大量数学与代码练习题上自己琢磨哪些思考策略有效)。这是 Karpathy 在白板图上把它补到 pre-training 与 post-training 之间的位置。RL 阶段,模型会在大量数学、代码类练习题上自己琢磨哪些思考策略有效:试错、回溯、重审假设。这些策略很难由人类标注员硬编码,全靠模型在大量题目里反复试出来。DeepSeek 那篇《Incentivizing Reasoning Capabilities in LLMs via Reinforcement Learning》是首次系统公开这一方向的论文。
所谓"思考模型",就是经过 RL 调优、带可选思考气泡的那类模型。Karpathy 的实操经验是他最近卡在一段多层感知机的梯度检查代码上,bug 不知在哪。他把同样的提示词扔给五款模型:
- O1 Pro(200 美元/月档):思考约一分钟后正确指出参数打包/解包不匹配。
- Claude 3.5 Sonnet(非思考型):同样给出正确答案。
- Gemini 普通模式:未启用思考模型也解决了问题。
- Grok 3:经过一番推理后成功定位 bug。
- Perplexity + DeepSeek R1(思考型):可视化展开思考过程——它逐步检查梯度累积顺序、发现参数打包出错、最终给出正确答案。
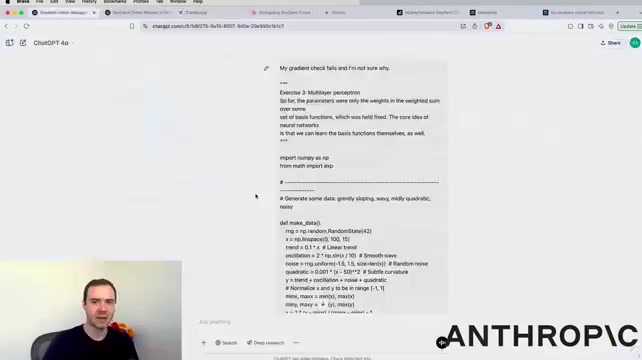
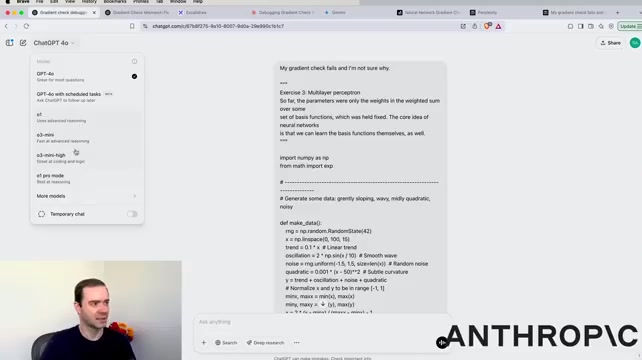
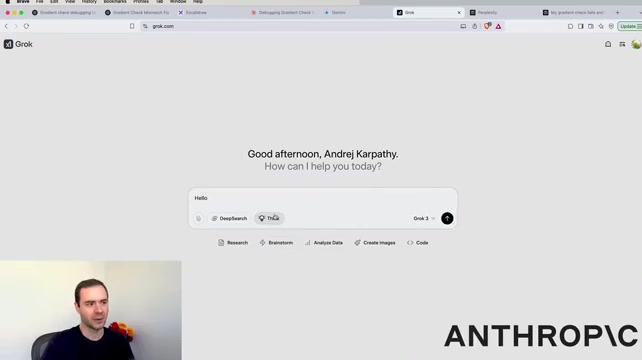
他的使用建议很简洁:默认先用快速非思考模型;怀疑质量不够时再切换到思考模型。在 Grok 这类应用里,新对话里勾选"think"开关即可让模型在底层切换为思考版本。
04 联网搜索:让模型替你查最新的事
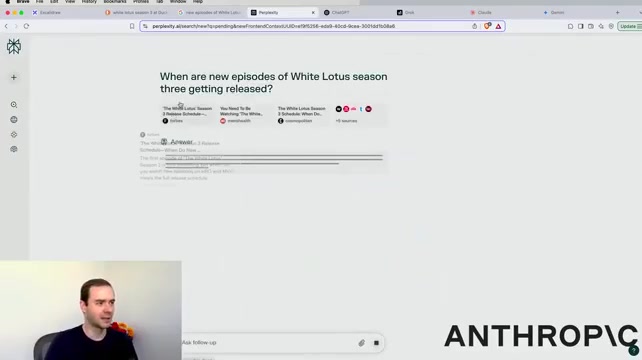
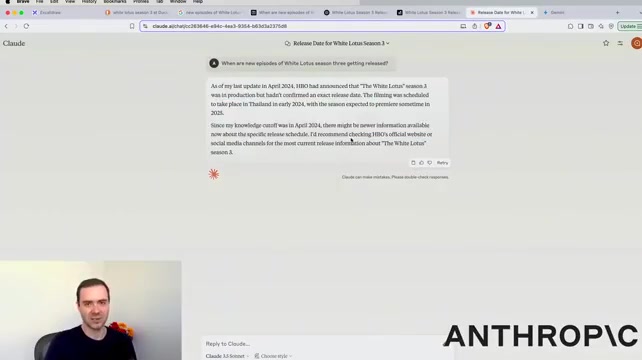
模型默认是"封闭的压缩文件",不会主动看时间。Karpathy 演示的痛点是:几天前他想知道《White Lotus》第三季什么时候播出,传统做法是手动 Google 搜索,但搜索结果里满是广告,体验糟糕。
他给出的解法是让模型发出特殊 token,告诉应用层暂停采样、执行查询、访问页面、把数千 token 的内容塞进上下文窗口、再据此回答。这套机制在白板上画得很清楚——ZIP 文件旁边多了一个「internet search」小图标,连着一条「Tool use → context window」的新链路。
工具选择上他最常用 Perplexity.ai(第一款真正令人信服实现「LLM + 联网搜索」的应用,自带引用来源),方便回查排除幻觉。ChatGPT 也加了 "Search the web" 按钮,效果类似。Claude 当时还没有联网搜索,所以问 White Lotus 时直接回了"As of my last update in April 2024";Gemini 2.0 Pro Experimental 同样不支持联网;2.0 Flash 支持但不给引用。这是产品当下最让人困惑的设计:最强模型没联网,有联网的反而没引用。
何时该用搜索工具,他的判据是"答案在前几条链接里就能找到"——比如当天是否股市休市、《White Lotus》第三季拍摄地、Vercel 是否提供 PostgreSQL、Apple 明日发布、《文明 7》发售日、Brian Johnson 用的牙膏、Palantir 股价为何上涨。这类问题时效性强、模型知识不覆盖,是搜索工具的甜蜜区。
05 Deep Research:十分钟出一份定制报告
联网搜索的下一步是 Deep Research(联网检索 + 长时推理的组合)。这一组合自动运行十余分钟。ChatGPT Pro 档最早集成这一能力,Perplexity 跟进做了同名功能,Grok 叫 Deep Search 但实质相同。
Karpathy 演示的 prompt 是研究 Brian Johnson 抗衰补充剂里的 CAKG(2.5g 每份,Brian Johnson 抗衰配方中的成分),需要覆盖功效、机制、毒性等。模型启动前会先问澄清问题(研究范围是人体/动物、是否纳入比较等),然后并发跑大量联网搜索、阅读多篇论文、思考推理、最终输出报告。报告里附引用来源,方便后续逐篇深入。整个白板图替换为只保留两条线:搜索 → Deep research → 反映思考 → 多个筛选条。
他个人用了约 10–20 次深度研究,目前 ChatGPT 的 Deep Research 效果最好(内容最详尽、最易读);Perplexity、Grok 偏短、深度不足。但有一个重要的定位——输出必须当作初稿使用(仍可能产生幻觉或被误读,引用来源是后续核查的索引,不是结论的替代)。
他举的三个案例各有说明:
- Brave vs Arc 浏览器隐私性对比:报告结论 Brave 显著更优,他因此切换到 Brave。
- 小鼠延寿研究:生成长篇综述,作为阅读清单。
- 美国 LLM 实验室规模与融资:输出表格但准确度参差——漏掉了 xAI(重大遗漏)、误纳入了非美国公司 Hugging Face、EleutherAI 因规模有限不应列入、数字未完全核实。
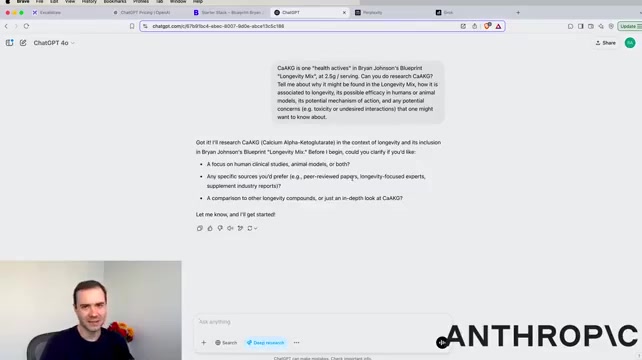
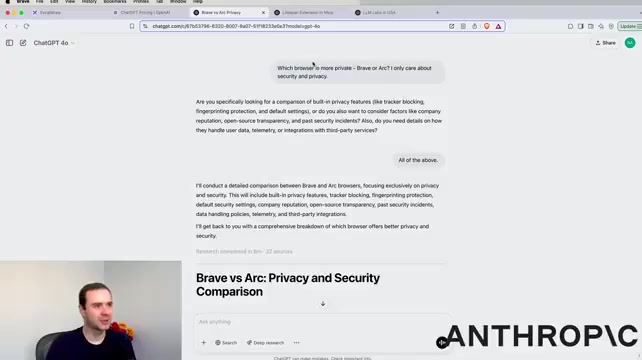
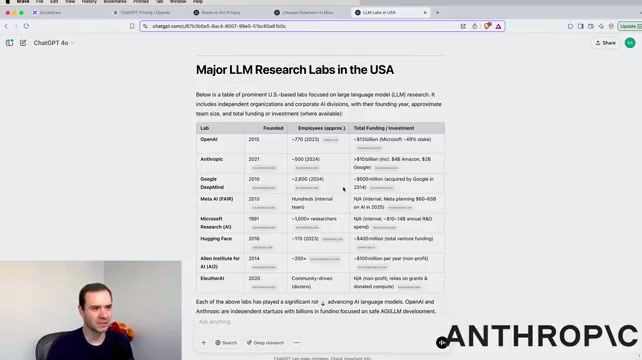
最后一条提示:Deep Research 的本质是让模型手边有具体参考文档(相当于人在答题时引用外部资料),而非仅依赖参数化记忆。
06 读论文、读书与 Python 解释器
把模型与外部世界连接的另一类工具是文件上传 + Python 解释器。
读论文的常用做法:把 PDF(动辄几十 MB)直接拖进 Claude,底层大概率转成文本载入 token 窗口(图片可能被丢弃)。Karpathy 的习惯是先让 LLM 总结论文,例如最近读一篇介绍跨生命域基础模型 EVO2 的论文,从摘要、导言开始持续向 LLM 提问,能显著降低理解难度。
读书他基本不再独自读。最近在读亚当·斯密 1776 年的《国富论》——古典经济学奠基之作,洞见至今仍贴切。流程是在 Project Gutenberg 拿到原文,定位到「卷一 论分工」一章。该章核心:分工受市场规模限制,市场太小则无法专业化,而专业化是财富创造的关键。他把章节文本粘贴进 Claude(虽然 Claude 对该书有背景知识,但未必记得具体章节内容,必须显式载入上下文窗口),让模型先给章节总结,再自己精读、随时提问。这种交互式阅读的体验"非常高效",但工具体验笨拙——理想形态是阅读时随手高亮段落即可向模型提问,目前还没有做到这一点的产品。
让 LLM 调用 Python 解释器是另一类强能力:模型输出特殊令牌表示"这是一段需要被执行的程序",应用层执行后把结果文本返回给模型,再由模型向用户呈现。简单心算(如 30×9=270)模型自己完成;复杂题(如大数相乘)模型必须切换到工具模式。ChatGPT 已训练去识别"不能心算"的题目并自动调用工具,Grok 3 没配 Python 解释器、心算出错,Gemini 看似没调工具但在难题上也会算错。
强场景是 ChatGPT Advanced Data Analysis(相当于一位初级数据分析师),能与你协作完成复杂数据任务。演示里让 ChatGPT 搜索 OpenAI 历年估值、生成表格、用对数 y 轴绘图。但有两个坑:① 2015 年 NA 被悄悄替换成 0.1(即隐含假设 2015 年估值 1 亿美元),未告知用户,必须审阅代码;② 拟合趋势线外推到 2030 年时,口头报"1.7 万亿"但图上打印的是 20 万亿(20271.7b)——这是典型的"幻觉"案例,工具虽强,使用者仍要具备读代码的能力。
07 Artifacts 与 Vibe Coding:从聊天到写代码
ChatGPT 的 Advanced Data Analysis 展示了"LLM 写代码 + 渲染图表"的能力;Claude 的 Artifacts 则更近一步——让模型就地写应用。Karpathy 演示里,把 Adam Smith 维基百科导言粘贴进 Claude,要求生成 20 张闪卡,模型输出问答卡片;继续让 Claude 用 Artifacts 写一个闪卡练习 App,模型用 React 写组件、Q&A 硬编码到组件中、界面在浏览器里加载——得到一个可点击翻面、判对错、重置、洗牌的交互应用。
Artifacts 的限制是只有前端、没有后端和数据库,但功能仍可相当复杂。新范式不再是"软件工程师预制应用 + 自定义(如 Anki 导入)",而是LLM 即时为用户编写并部署专属 App。
职业开发工作流则需要 Cursor、Composer 这类独立应用。Karpathy 主要用 Cursor(本地程序、能读取文件系统、调用 Anthropic API),用户无需手动复制粘贴代码。演示里从零搭 React 井字棋项目,只写了五句,AI 完成了 CSS/JS 全部代码。工具演进路径是:Cmd K(单行修改)→ Cmd L(代码解释)→ Cmd I(Composer 是代码库上的自主代理,可执行命令、跨多文件编辑)。他提到"vibe coding"(氛围编程)这个词是他最早提出来的,意思就是"把控制权交给 Composer,告诉它你想要什么,然后期待它把事情做对"。
Vibe coding 撞上无法调试的问题时,仍可退回到常规编程方式(所有源文件都摆在那里,可以随时打开 CSS 逐项检查),随时可查。
08 多模态:语音、图像、视频
除文字外,模型正被快速赋予更多模态。
语音输入:Karpathy 个人约一半查询用键盘、一半懒得打字用语音;手机上语音查询比例高达 80%。在 Mac 桌面端,他借助 Super Whisper 等系统级 STT 应用(快捷键 F5 启动监听、再按 F5 停止),把语音转写为文本再发送给 ChatGPT。当查询涉及产品名、库名等易转写错误的内容时,他会手动输入以确保准确。
语音输出(TTS):多数应用提供"朗读"功能把回答文本转语音读出,ChatGPT 有 "Read aloud" 按钮。但以上都属于「假音频」(本质仍是文本交互,只是 STT/TTS 模型在前后做转换)。「真音频」技术则是把音频切成频谱小块、量化成 token、形成约 10 万种音频词表,让模型直接训练理解这些音频 token。ChatGPT 的 Advanced Voice 模式(移动端提供)就是真音频的实现——系统内部传输的是音频 token,文字只是转录结果。
Advanced Voice 模式表现保守,常拒绝请求、语气尴尬,但在合适场景下仍值得体验;Grok 提供多种放飞模式(默认/浪漫/Unhinged/阴谋论/Sexy),几乎不拒答,适合娱乐向体验。
播客生成:NotebookLM 接收原始文本、网页、PDF 等资料作为上下文窗口输入,可进行问答;右侧 Deep Dive 播客生成按钮按下后几分钟即可生成约 30 分钟的定制播客;Special Instructions 可定制主题、Interactive Mode 支持中途打断提问。Karpathy 把自己生成的播客系列《Histories of Mysteries》上传到了 Spotify。
图像:与音频类似,图像可被切分成网格 patch、量化到约 10 万大小的 patch 词表,由语言模型统一处理。先 OCR 再问的两步法很常用——先把图像中文字转录成文本,确认模型识别正确,再针对文本提问。例如把 20 页血检 PDF 一张张截图上传、确认每张正确识别后让模型解读,多轮对话迭代拼出完整结果。关键注意两点:① 仔细核对转录是否正确;② 流程便捷(Mac 用截图快捷键框选屏幕区域、直接粘贴进 ChatGPT)。血检属于互联网资料丰富领域,模型对数值与范围的解读可信度较高,但最终仍应与医生确认。
图像生成:Karpathy 个人不常用,主要用来生成图标、缩略图等素材,常用 DALL·E、ideogram.ai、ChatGPT 交叉使用。DALL·E 3 的图像输出并非端到端,模型先生成图像描述(caption),再交给独立图像生成模型拼接。
视频理解:让模型"看"视频,目前是 Advanced Voice 的一部分,仅手机端可用。演示里模型通过摄像头实时识别墙上的黑色吸音棉、《Genghis Khan and the Making of the Modern World》、《Surely You're Joking, Mr. Feynman》、Aranet 4 CO₂ 检测仪、托尔金《魔戒》地图。
观点类问题通常被模型回避("我只是 AI"),但 ChatGPT 偶尔会给出明确判断(例如认为好莱坞最后一个真正巅峰是 1997 年到 2000 年代初)。
09 记忆与定制:让模型懂你
新对话从空 token 窗口开始,旧内容会被清除。ChatGPT 的 Memory 功能可跨对话保存信息——可由系统自动触发,也可手动要求("请记住这点")。触发后模型会写入对用户的总结到 memory bank,类似独立数据库、自动前置到所有对话开头。记忆以文本字符串存储,支持编辑、添加、删除。Karpathy 认为该功能目前为 ChatGPT 独有,可显著提升电影推荐等相关回答质量。
Custom Instructions 是跨对话的全局调整——例如让 ChatGPT 别像 HR 商务伙伴、用正常语气交谈,并尽量给出解释与洞见;自我介绍也写进 custom instructions,告诉模型自己的身份;学韩语时统一使用指定语气的韩语输出。其他 LLM 设置里通常也能找到该选项。
Custom GPTs(适合一次性配置、反复使用的高频任务)。Karpathy 演示的 Korean Vocabulary Extractor,输入句子、输出"韩语;英语"格式的词典形式词汇表,可直接粘贴进 Anki 闪卡应用,把句子一键变闪卡。实现方式是纯 prompt(在编辑 GPT 的 instructions 字段里写任务 + 四条具体示例),构成 few-shot prompt(少样本提示),比 zero-shot 显著提高准确率。
翻译场景里他自建了 Korean Detail Translator(先整体翻译再逐词拆解、输入/输出用类 XML 标签标注示例起止),构成 few-shot 提示;ChatGPT 翻译效果远超普通翻译器(能理解语气、俚语等细微差别)。
视频字幕学习场景下的 Korean Cap 应对像素化("烤"进画面)的字幕:将剧照截图粘贴进去,OCR → 翻译 → 逐词讲解,可随时调用。GPTs 功能目前为 ChatGPT 独有,但其他 LLM 应用可能在设置里有类似入口。
10 编者按:边界、口径、判断与今天就能跑的第一步
边界先摆三条——其一,这场讲座是 Karpathy 现场演示的产物,所有模型与工具的具体表现会因版本、API 参数、上下文窗口设置而异;他在演示时明确说了"this is a pretty good first pass"。其二,模型与工具的迭代极快,——DeepSeek 论文是约 1–2 年前的工作,Claude 当时还没联网、Gemini 2.0 Pro 当时不能联网,Perplexity / Grok 的深度研究还在追赶;今天的情形又不一样了,动手前以你手头模型的最新文档为准。其三,讲座全程以讲者口播+实操为主,所有数字、订阅价格、模型名、API 示例都以讲者实操为准,本文未补 2024–2026 年间的产品演化、未补模型版本号与发布日期、不外推讲座之外的工具能力。
素材口径也要交代:本文事实只取自这场 2 小时 9 分 6 秒的讲座(视频原帖由 X 账号 shobhanai / @HeyShobhan 发布;讲者 Karpathy 的身份以视频自我介绍为准),未外引素材之外的事实——不补 Karpathy 在 OpenAI / Tesla 工作年份、不补他后续的 nanoGPT / Eureka Labs 项目、不外推各家 LLM 在讲座之外的产品更新。讲座的脉络是 Agents → Loops → Harness → Self-Improving Systems——本文按 10 章节顺序展开,不覆盖讲座里所有细节但保留了核心机制与可操作落点。
编者判断说一句。这场讲座真正值得记的不是某条 prompt 模板,而是把模型当作压缩文件这一隐喻——它解释了知识截止、参数幻觉、不同模型档位差异、工具调用的本质("把上下文窗口当作工作记忆")。讲座反复回到同一个动作:把模型放在合适的位置上,让它手边有对的信息、对的工具、对的思考时间。另一条是"先快速模型、不行再思考模型"——这条建议适用于一切日常工作流,比起默认开思考模型省下的时间与 token 是可观的。真正能迁移的不是某个 UI 里的开关,是把模型当合作者而不是当答案机器这一判断。
若只带走一个动作:今晚打开一个 ChatGPT 新对话,把刚才那段「美式咖啡因约 63 mg」的问题问一遍,再复现 Karpathy 的 NyQuil 成分追问——亲手过一遍"常识型问答该不该信"的判据。然后在新对话里勾选 think 开关再问一次梯度检查那道题,看看思考模型与快模型在你的任务上差异有多大——这就是讲座里"默认快、不行再切换"那条建议的最小验证。
原作者:Andrej Karpathy;本文观点出自其约两小时免费讲座(视频全长 2 小时 9 分 6 秒),视频原帖由 X 账号 shobhanai(@HeyShobhan)发布。