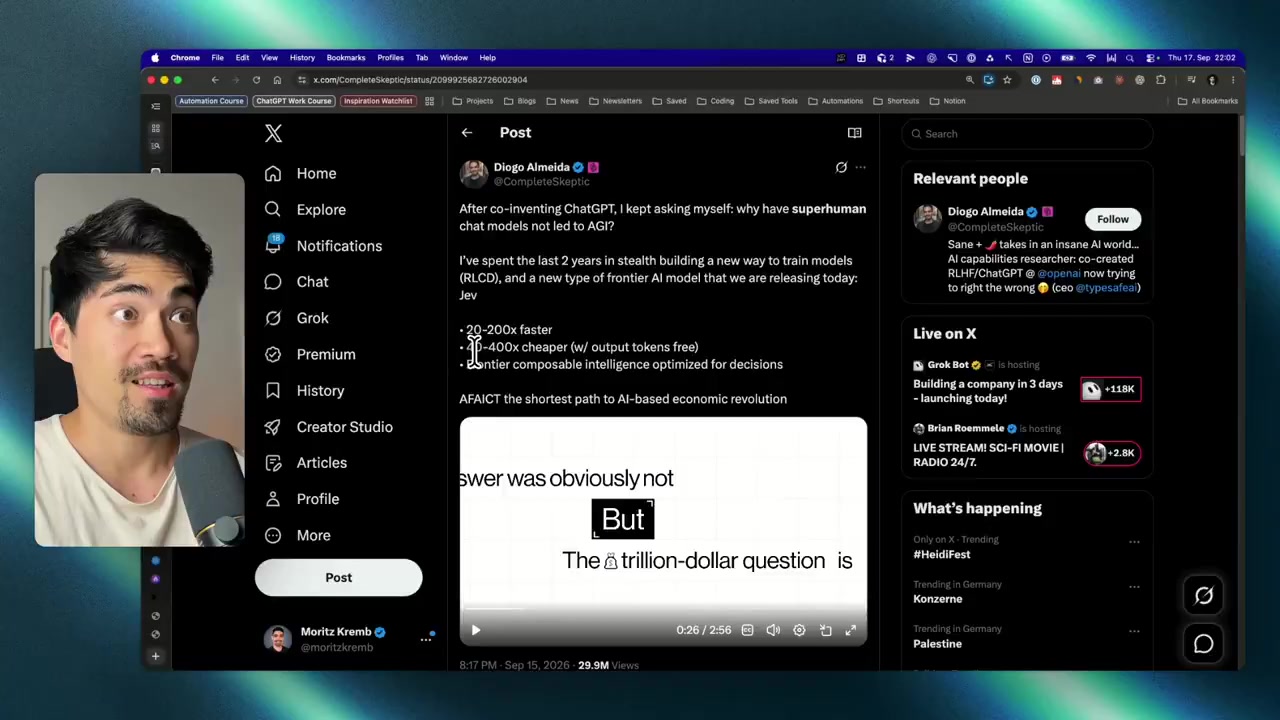
编者按:本文观点与全部演示出自 Moritz Kremb(@moritzkremb)发布在 X 上的实操视频,经 @AYi_AInotes 转发整理;「快 20 到 200 倍、便宜 40 到 400 倍」是 typesafe.ai 的官方口径,其余数字除注明外均来自演示画面。视频录制时 Jev 仍需候补名单才能使用。
如果你正在把高频小判断交给大模型——这句语音要不要执行、去哪份笔记里找答案、哪条标题更值得做——多半已经撞上同一堵墙:LLM 逐 token 生成,一个判断要等好几秒、烧几千个 token,答完了你还得从一整段话里把判断本身抠出来。typesafe.ai 发布了一个专吃这类活的模型 Jev;发布仅两天,Moritz Kremb 就在它上面搭出了 3 个能跑的真实项目:语音控浏览器、个人操作系统的记忆检索、YouTube 标题打分器。本文按 29 张截图加关键时点的视频帧逐段核过一遍,3 条提示词保留英文原文可直接抄走,转写里 Jev/Jeff 混用的拼写统一为 Jev。
01 它不写答案,只指选项
先看发布现场。typesafe.ai 创始人 Diogo Almeida(自称 ChatGPT 与 RLHF 的共同创造者之一)在 X 上的公告帖写着:两年隐身研发新训练法 RLCD,今天发布新模型 Jev,快 20 到 200 倍、便宜 40 到 400 倍、输出 token 免费,定位是「为决策优化的前沿可组合智能」。
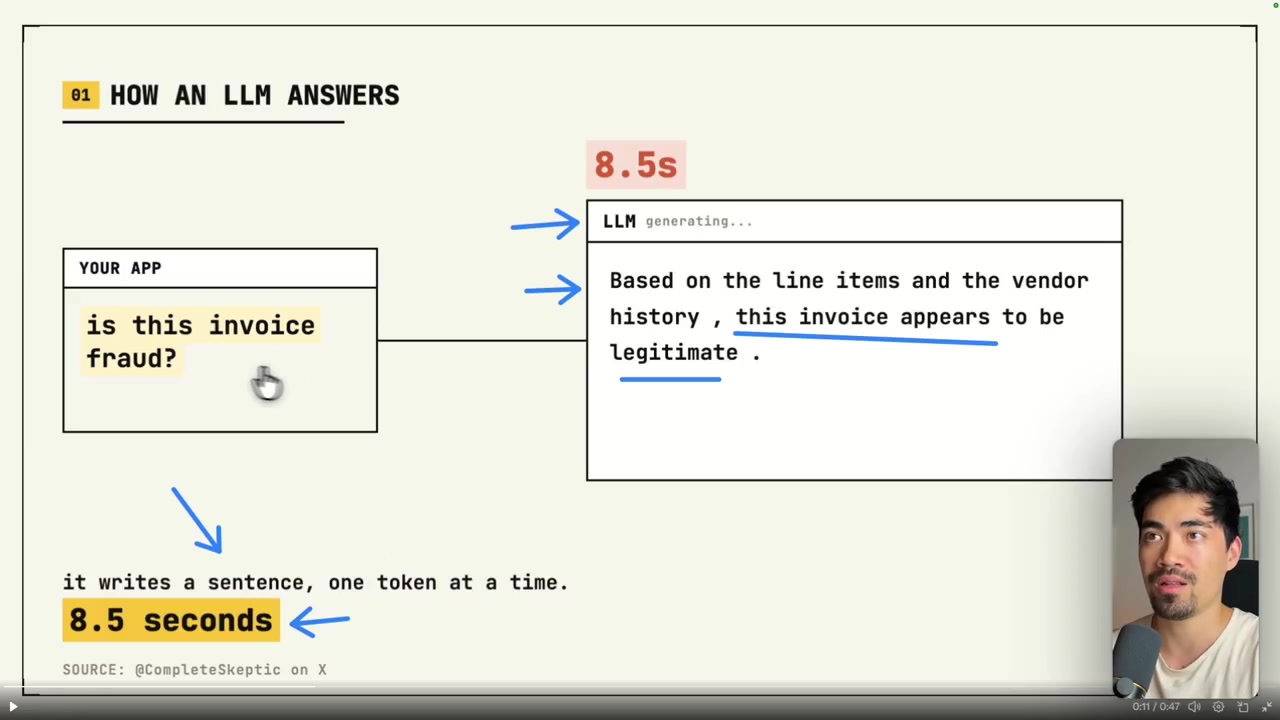
Diogo 的账号 @CompleteSkeptic 随后放出一支 47 秒的讲解视频,Moritz 的教程直接引用了它。第一组对比是「这张发票是否欺诈」。LLM 的做法是写一整句话:基于明细条目和供应商历史记录,这张发票看起来是合法的——逐 token 生成,画面计时 8.5 秒。
Jev 收到同一个问题,输出不是文本,而是一张你预先定义的选项打分表:欺诈 0.07、正常 0.88、需复核 0.05。没有 token,一次并行扫描把所有选项同时打完,计时 0.1 秒。讲解视频的原话值得记:它不会写,它只是指向你的选项之一。
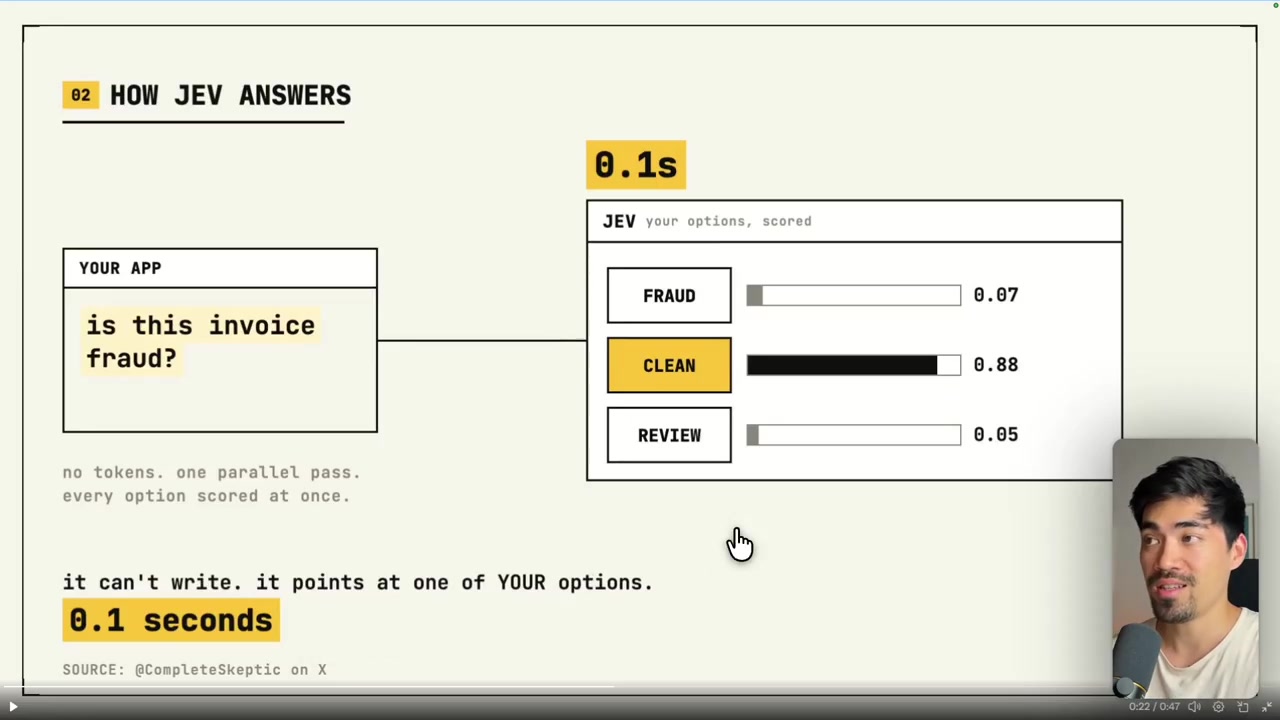
所以这是两种东西,不是同一个模型的快慢两档。LLM 是生成器,Jev 是判断件:你给它固定的选项集合,它返回每个选项的概率。它省掉的时间,正是「把判断写成句子、再把句子读回判断」这两道来回。
02 能力边界:用「不会写」换来的快
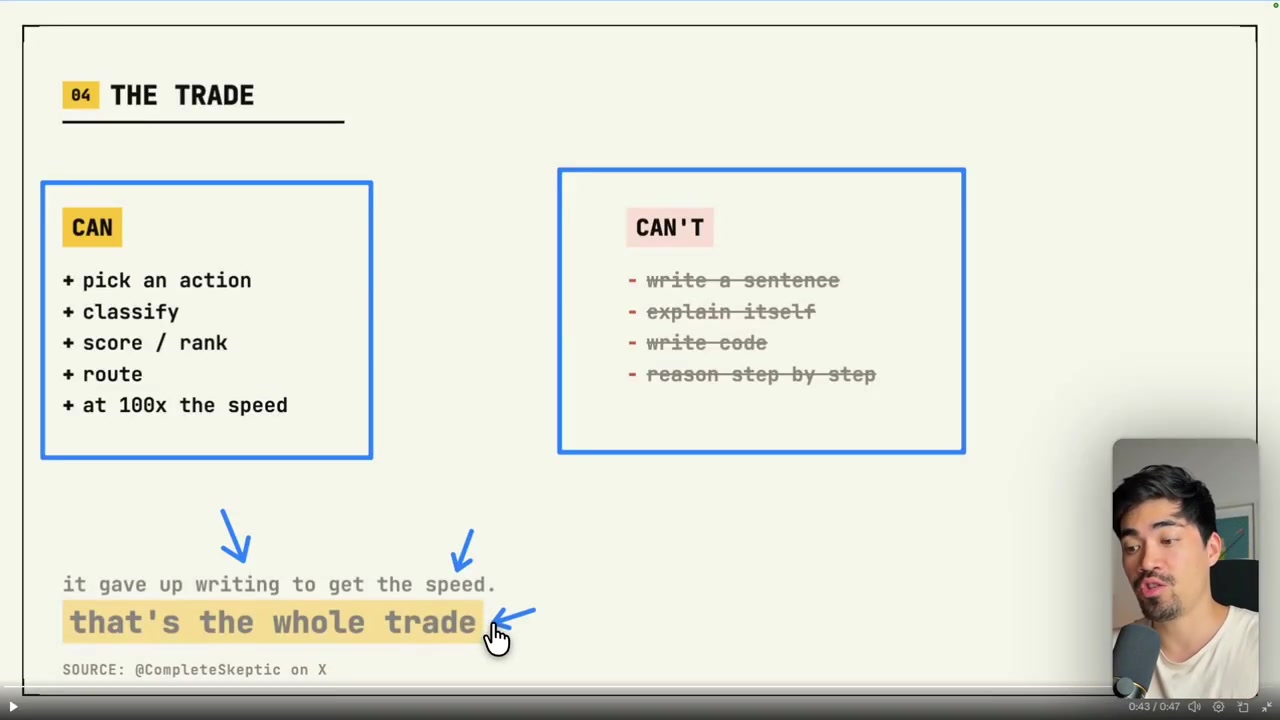
官方把能力边界压在一页幻灯片上。能做:选动作、分类、打分、排序、路由,速度乘以一百。不能做:写句子、解释自己、写代码、逐步推理。幻灯片那句总结很诚实:它用放弃写作换来了速度,这就是全部交易。
一个能感知边界的例子:游戏角色每个时钟节拍要从左移、右移、前进、开火里选一个动作,Jev 快到能坐进游戏循环里实时驱动角色,LLM 的响应速度根本跟不上游戏节奏。
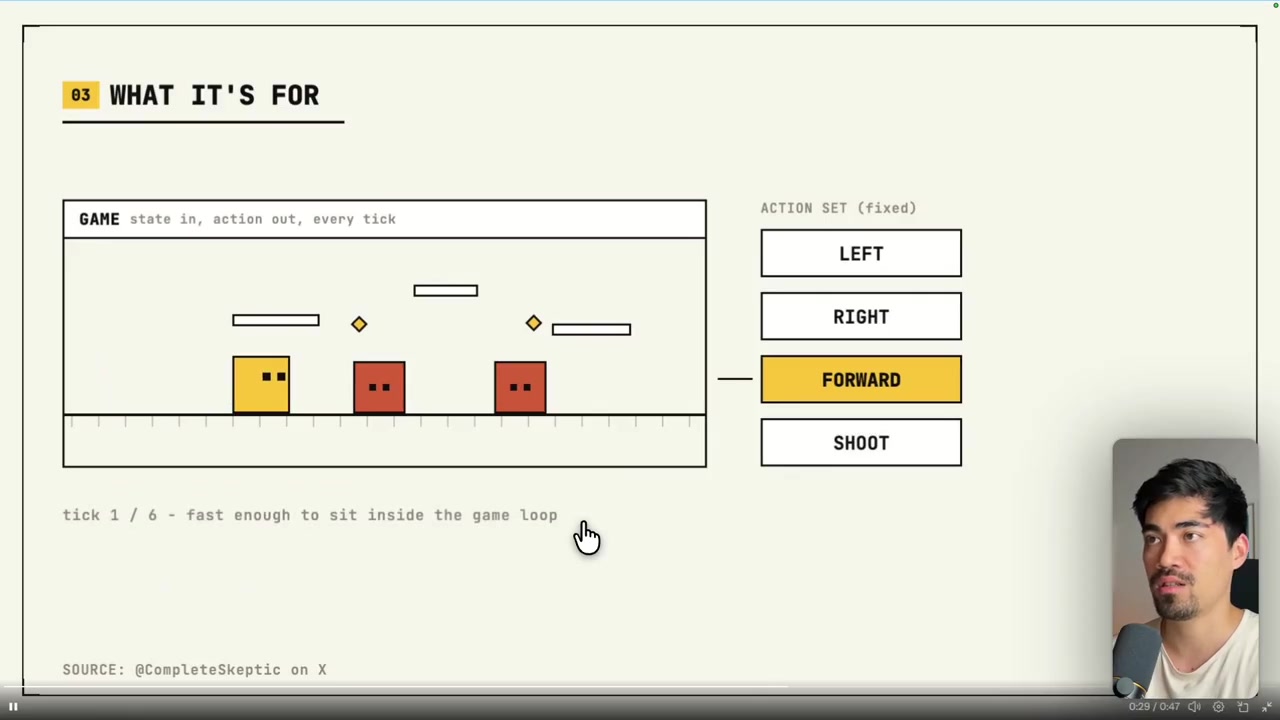
这件事为什么值得注意?因为软件本质上就是一大串「如果……那么……」:如果用户在骂人就转人工,如果这张发票可疑就冻结,如果上下文超限就压缩。这些判断过去要么写成死规则,要么交给又慢又贵的 LLM。Jev 给出第三条路,官方给的最佳实践也是组合用法:Jev 在毫秒级决定「下一步做什么」,需要深推理或长文本时再调 LLM。下面三个项目,就是这个组合的三种形态。
03 上手:从候补名单到让 AI 吃透文档
上手一共四步。第一步,打开 typesafe.ai,首页还挂着 Join Waitlist 按钮,资格分批放,演示者自己是早期才拿到的——换句话说,多数人现在还进不去,方法论先收着。第二步,通过后登录控制台,playground 里内置了示例请求(「热狗算不算三明治」这种),还有三种问题原语可以试:Evaluate(判断一件事有多真)、Score(按量表打分)、Choice(多选一)。
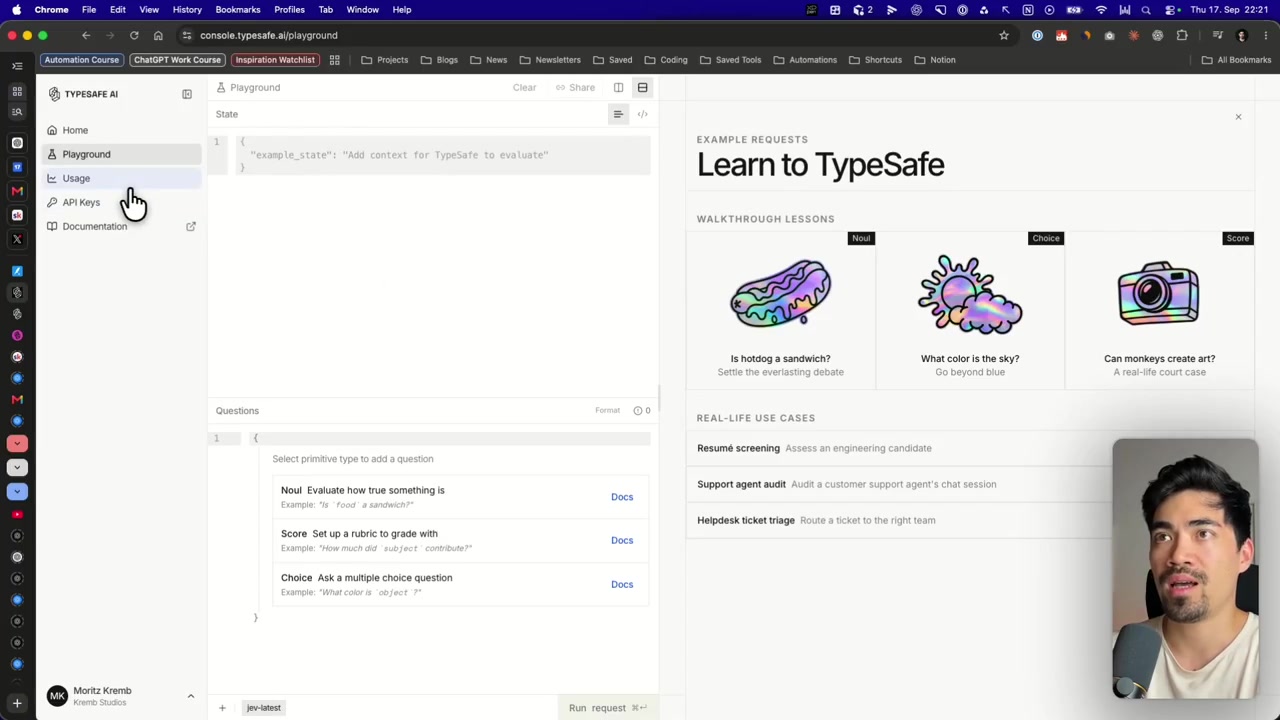
第三步,在 API keys 页建一个密钥,存进本地 .env 文件。第四步,打开 Cursor 新建项目,第一条提示词不是写应用,而是让 AI 把官方文档整个读一遍、压缩成项目内的知识库:
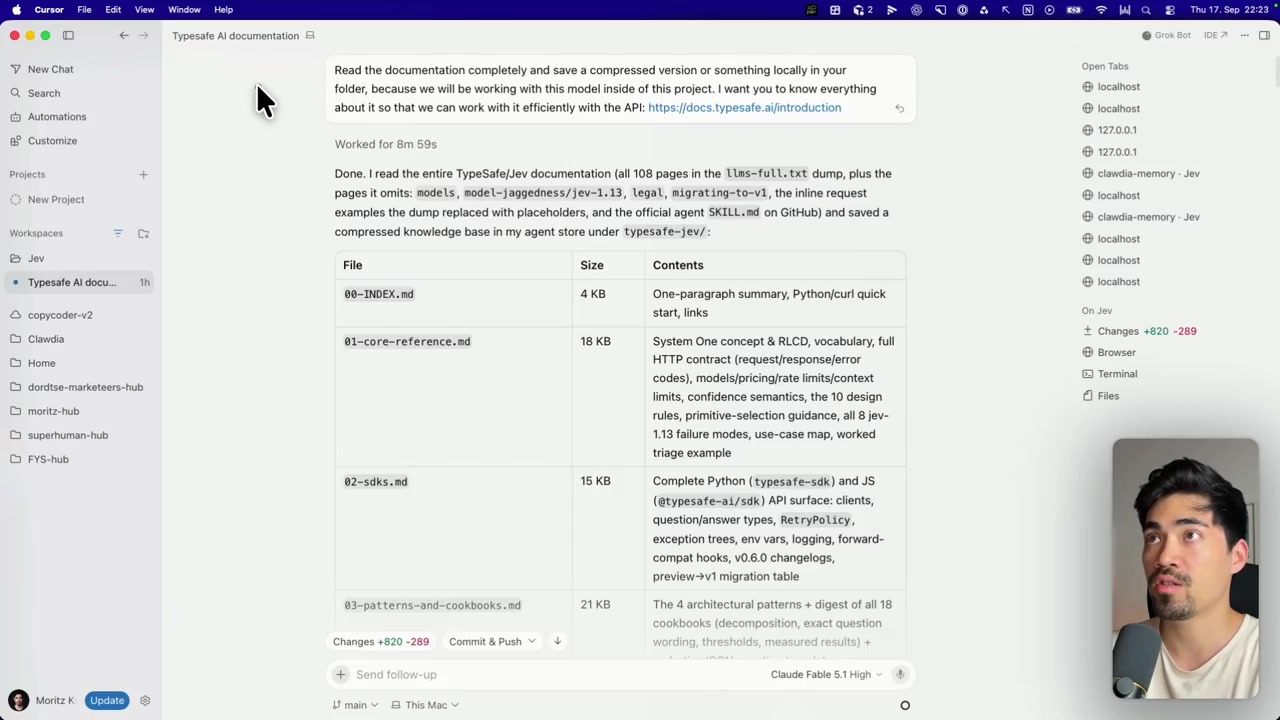
Read the documentation completely and save a compressed version or something locally in your folder, because we will be working with this model inside of this project. I want you to know everything about it so that we can work with it efficiently with the API: https://docs.typesafe.ai/introduction
这一步的效果值得看一眼:AI 干了 8 分 59 秒,读完全部 108 页文档,在项目里存下四个压缩文件——索引 4KB、核心参考 18KB、SDK 参考 15KB、模式与案例 21KB。此后项目里的 AI 就「懂」这个模型,写代码时不必再去翻网页。
04 项目一:语音控浏览器(提示词与实测账单)
第一个项目的提示词原文:
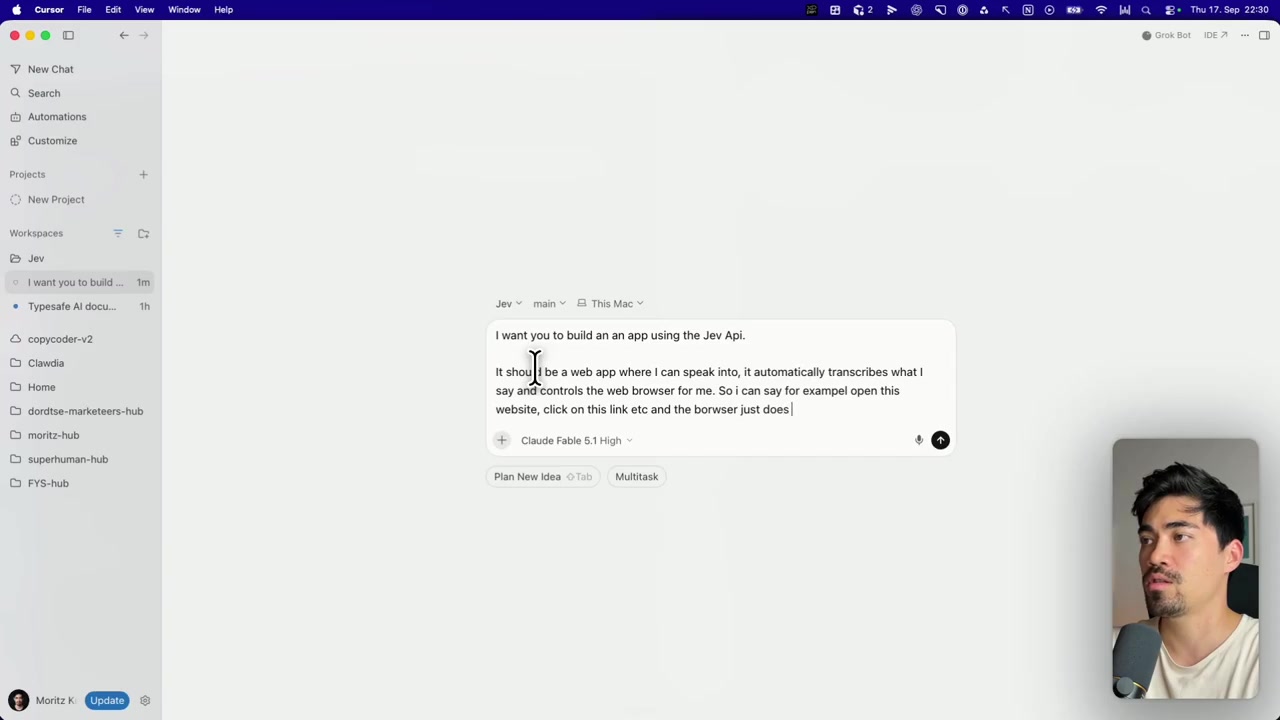
I want you to build an app using the Jev API. It should be a web app where I can speak into, it automatically transcribes what I say and controls the web browser for me. So I can say for example open this website, click on this link etc and the browser just does it.
跑完提示词,得到一个控制台页面加一个受控浏览器窗口。整场演示的账单就写在控制台顶上:模型 jev-1.13.0,每来一段新语音就发一次判断请求,单次 9 道题、5287 个输入 token、成本 0.000222 美元;从说完最后一个词到做出决定,中位数不到 300 毫秒。一场下来累计 16 次调用、6 个动作,总成本 0.0032 美元。
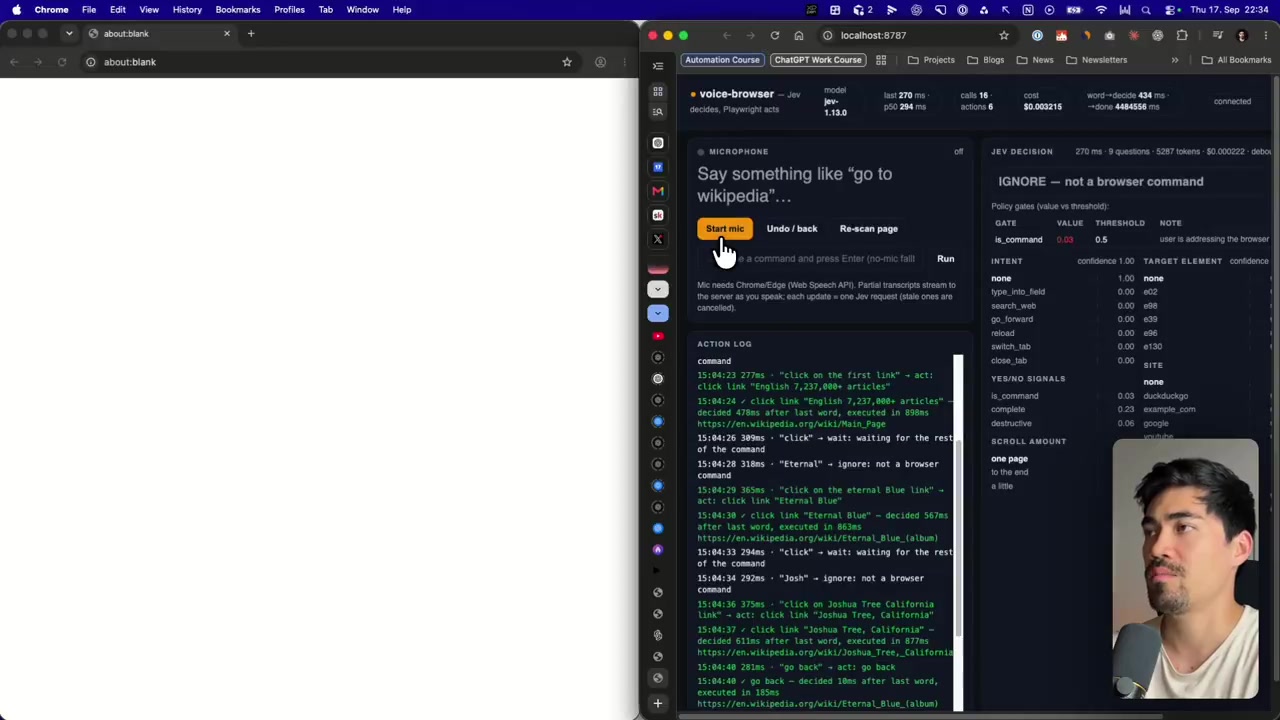
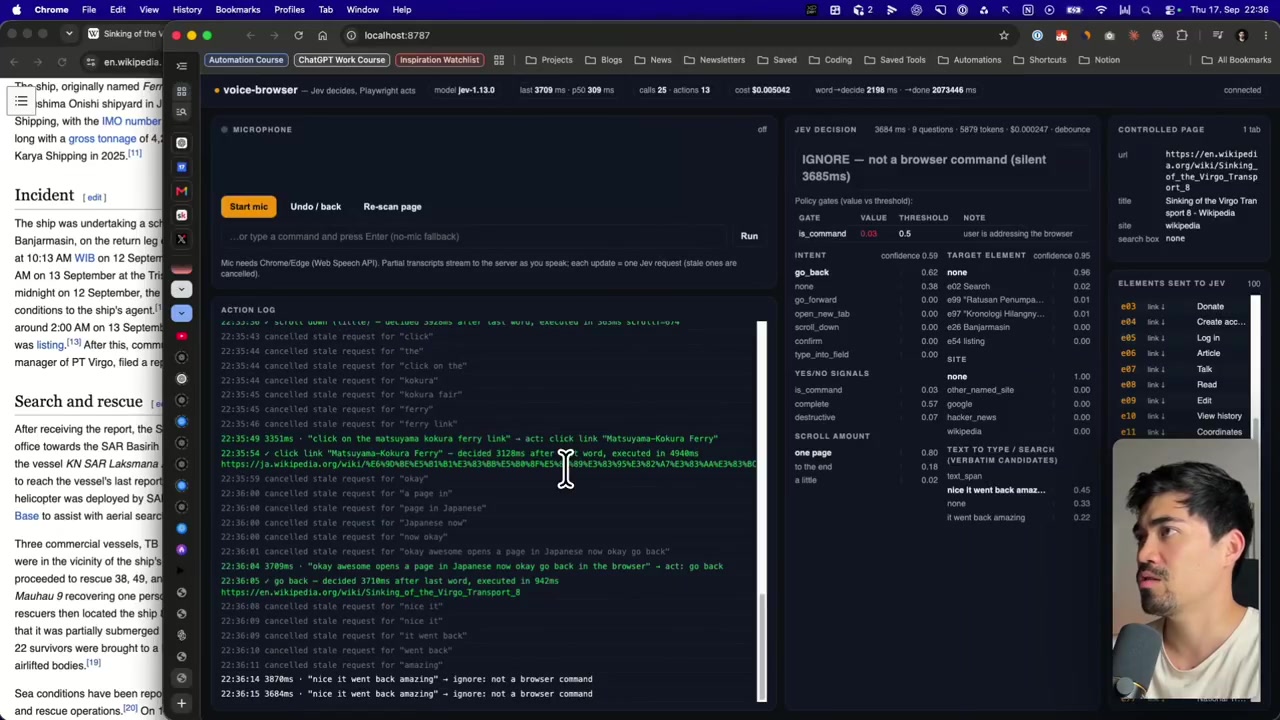
实测指令按画面动作日志还原:说「打开 wikipedia」,再说「点第一个链接」,浏览器点中的是英文维基入口,478 毫秒做出决定、898 毫秒执行;接着「点 Eternal Blue 那条链接」跳到专辑页;说到一半的「click」被挂起,等后半句;随口说的「Josh」被直接忽略;在渡轮失事报道的页面里说「点 Matsuyama-Kokura Ferry 那条链接」,3128 毫秒后点中,打开的是日文维基页面;一句「go back」371 毫秒决定、942 毫秒执行完。语音转写是流式的,每段碎片都触发一次请求,过期请求会被自动取消——日志里留了一长串 cancelled stale request。
05 六道判断题加两条阈值:语音 demo 的内部机制
这套东西为什么快?演示者让 AI 用大白话解释过一遍,机制拆开是三段。第一段传话:控制台页用浏览器自带的语音识别边说边转写,不等你说完。第二段 Jev 做选择题:Node 服务端扫描受控页面,列出最多 100 个可交互元素(链接、按钮),连同用户的话一起发给 Jev,附一组固定的判断题:
- 用户想做什么?(导航、搜索、点击、输入、滚动、返回……)
- 指的是页面上哪个元素?
- 说的是哪个网站?
- 这句话说完了吗?
- 用户是在对浏览器说话,还是在跟屋里的人聊天?
- 这个动作会不会购买、删除或发送什么?
第三段普通代码拍板:服务器里只有几条带阈值的 if 语句——「是条指令」的概率低于 0.5 就忽略;「句子说完了」的概率低于 0.6 就继续等后续语音;意图置信且句子完整才执行,由 Playwright 在受控浏览器里真正点下去。AI 的原话值得抄:Jev 不是聊天机器人,它什么都不写,只是给每个答案返回一个概率,大约 300 毫秒。
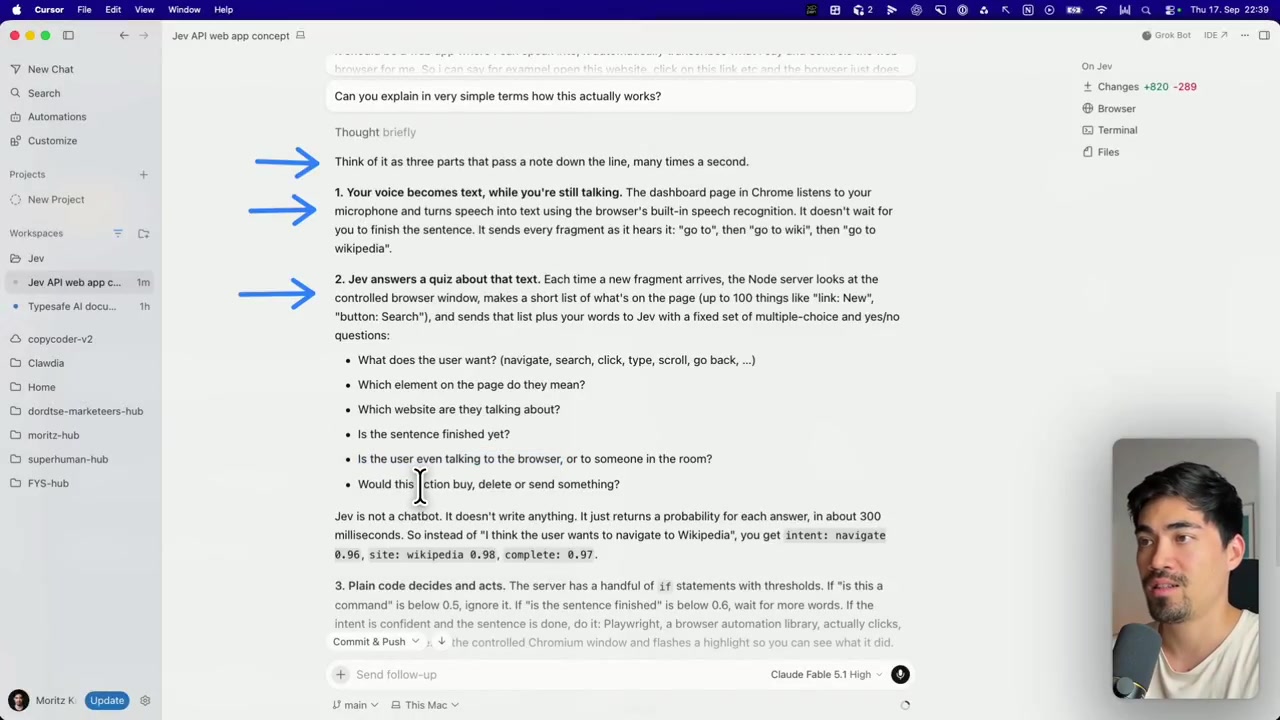
这六道题加两条阈值,就是概率输出替代 LLM 推理链的完整样板:判断被压成固定选项,规则代码即时触发,风险动作另有一道确认。想搬进自己的场景,改题不改架构。
06 项目二:Clawdia 记忆系统的旧账
第二个项目更贴近日常。演示者的个人 OS 叫 Clawdia——本质是一个文件夹,根目录放着 AGENTS.md、CLAUDE.md、SOUL.md、TASKS.md、MEMORY.md,加上一堆主题子文件夹,每次从这里发起的 AI 对话都会沉淀成记忆。画面上的体量:33 个主题文件、约 27 万个 token、159 篇每日笔记、880 个小节,最大的单个文件快 4 万 token。
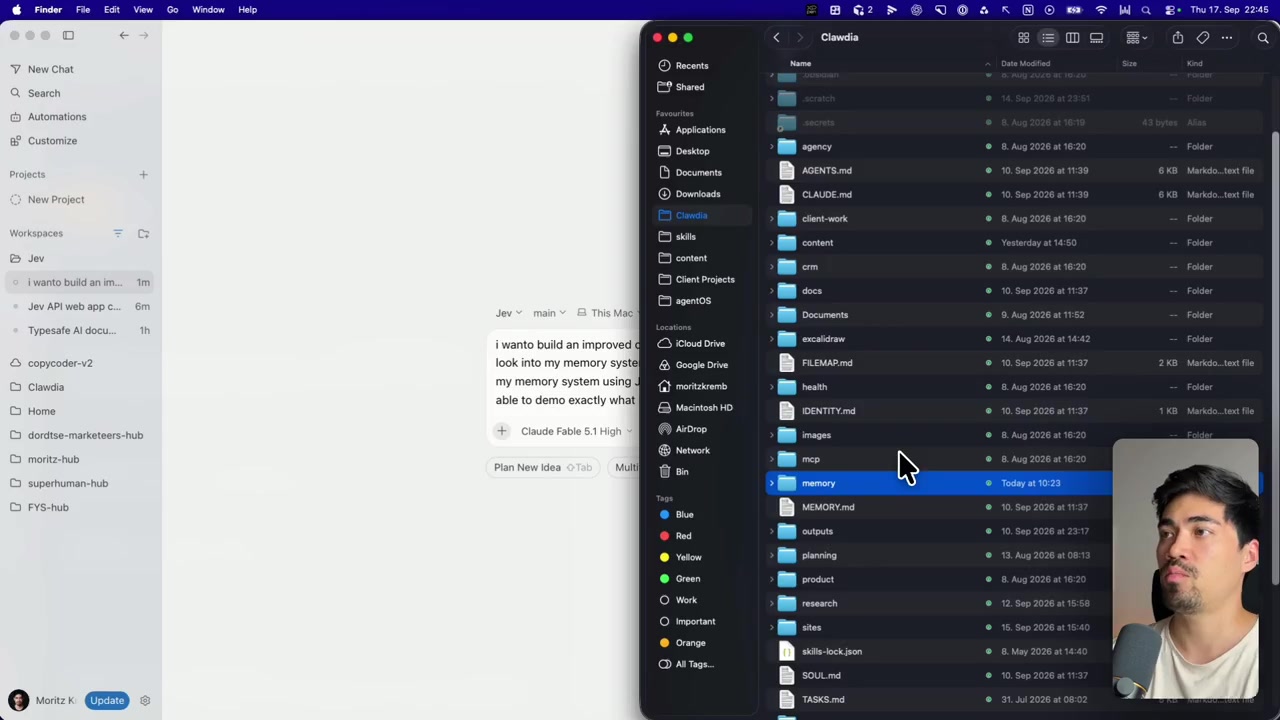
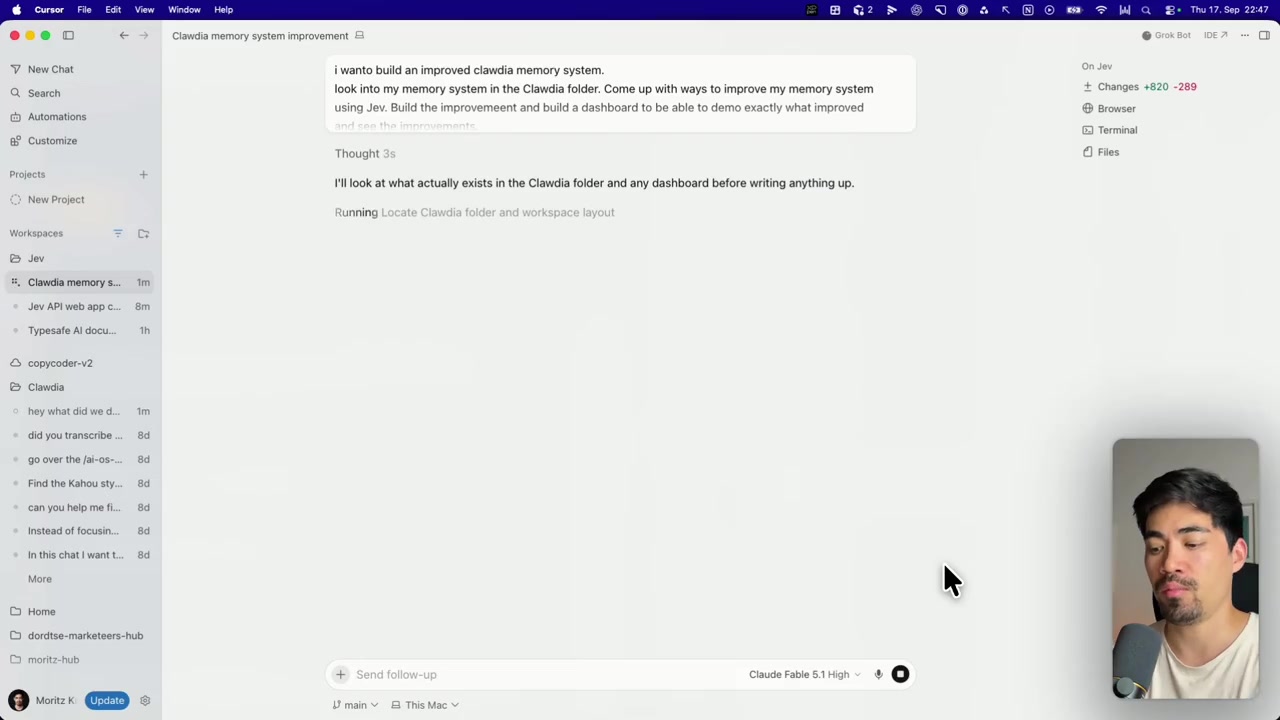
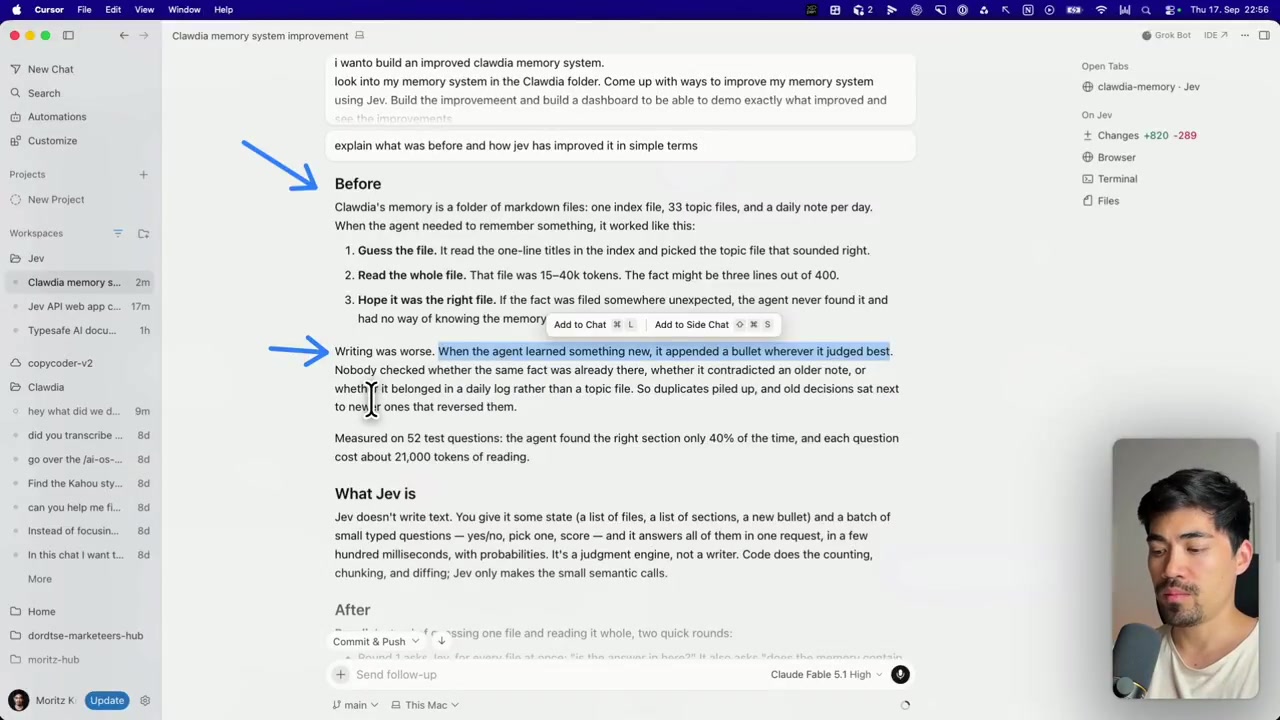
旧检索有多糟,是负责改进的 AI 自己量出来的:猜文件名、整读一个 15 到 40k token 的文件、祈祷猜对。52 道测试题实测,找对小节的概率只有 40%,每题平均读掉约 21000 个 token。写入更糟:新学到的东西不知道该追加到哪个文件,就塞进当天的日记,重复越积越多,被推翻的旧决策和新决策并排躺着。改进用的提示词原文:
I want to build an improved clawdia memory system. Look into my memory system in the Clawdia folder. Come up with ways to improve my memory system using Jev. Build the improvement and build a dashboard to be able to demo exactly what improved and see the improvements. Explain what was before and how Jev has improved it in simple terms.
07 判断引擎式检索:前后对比与一道边界题
AI 交出的新机制一句话讲清:Jev 在这里是个判断引擎,不是写作工具。给它一些状态——文件列表、小节列表、待写入的新条目——加一批小问题(是非、单选、打分),它一次请求、几百毫秒内全部以概率答完;计数、分块、比对这些脏活全由代码承担,Jev 只做小型语义判断。检索改成两轮:第一轮对每个文件同时问「答案在这个文件里吗」,还问一句「记忆库里到底有没有」——没有,就正面回答不知道,而不是硬凑一段不相关的内容;第二轮对选中文件的每个小节问「这节能不能回答」,过阈值的才交给 Agent。
面板上的前后对比,以下均为画面读数。「当前的 offer 定位是什么」:Agent 只摄入 2756 个 token,旧法要整读两个文件共 13408 个,少了将近八成,4 次请求、7 秒、0.00297 美元,答对了。「CRM 和邮件供应商之间出了什么故障」:293 对 13835 个 token,少 98%,2 次请求、0.00117 美元,也答对了。52 道测试题整体:找对小节的比例从 40% 提到 96%,Agent 平均摄入从约 21000 降到约 1200 个 token;画面上还写着,问题换个措辞问,标题关键词匹配的命中率掉到 5%,Jev 保持 92%——它读的是语义,不是词。
最狠的是边界测试:「Moritz 最喜欢的披萨配料是什么」,这个话题从未聊过。系统直接返回缺失,Agent 摄入 0 个 token;旧法会把一个一万一千多 token 的文件整个读一遍,还答不上来。
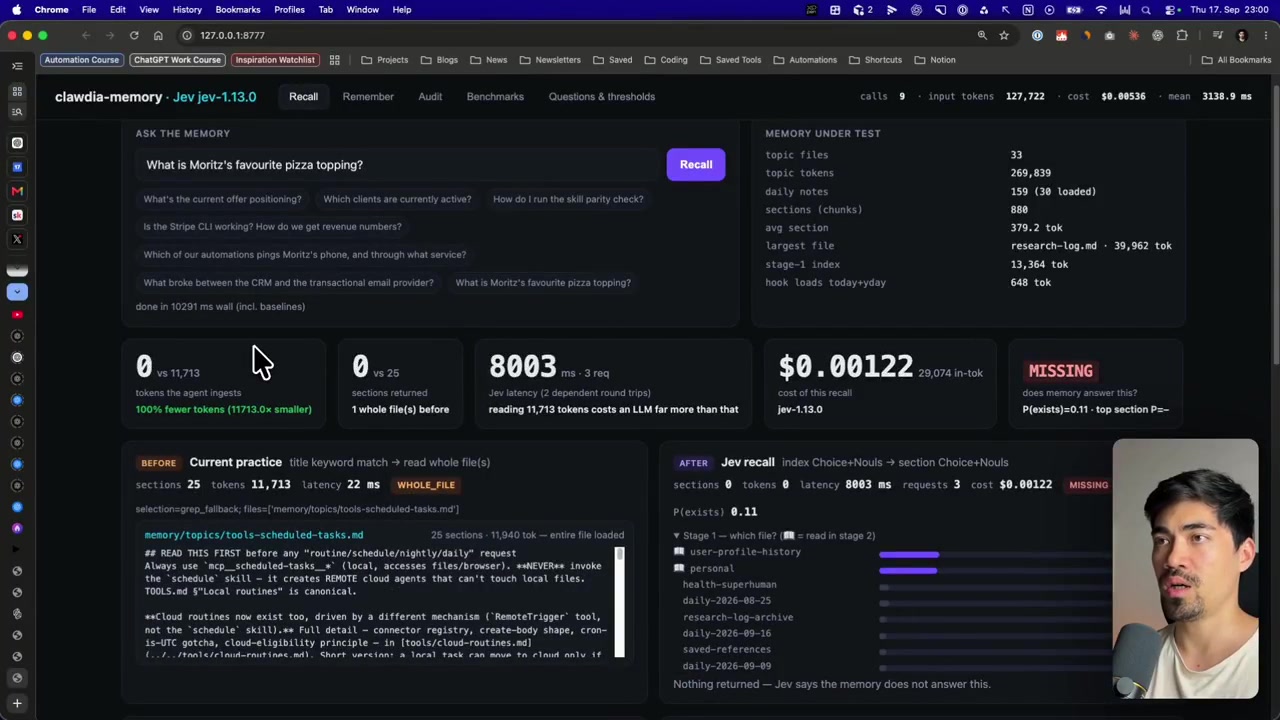
诚实起见也要记下代价:检索要两次依赖往返,上面几问都在 7 秒上下,换来的是下游 token、错误答案,以及「不知道就是不知道」。这是拿延迟换准确和成本,不是免费午餐。演示者也明说这仍是初始原型。
08 项目三:给 601 条视频训一个标题打分器
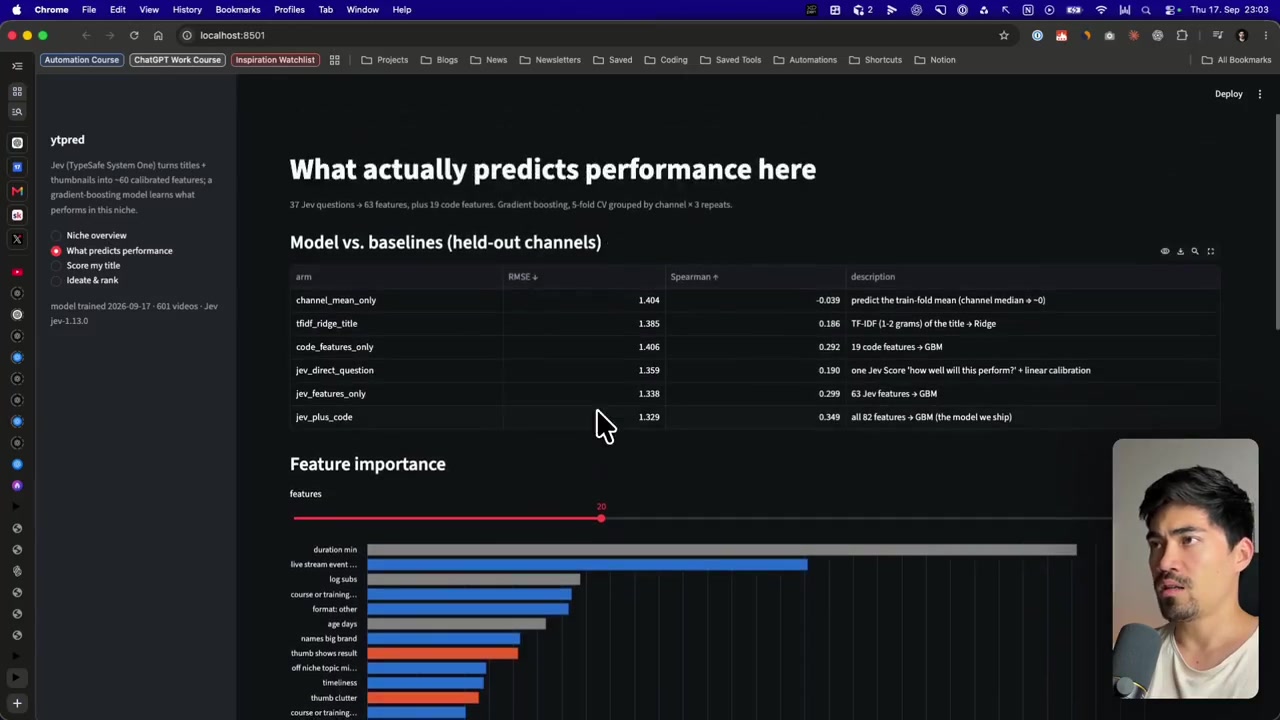
第三个项目的提示词没有原文入镜,大意是:抓取所在赛道的 YouTube 数据,用 Jev 做特征,训练一个预测选题表现的模型,配一个仪表盘。生成的工具抓了 AI 智能体教程赛道 15 个频道共 601 条视频(画面里能看到 NetworkChuck、Tech With Tim、Nick Saraev 这些频道名)。Jev 把每条标题加封面概念转成 63 个校准特征(37 道题),再加 19 个代码特征,喂给梯度提升模型,按频道分组做五折交叉验证。全流程 Jev 花费 0.23 美元。
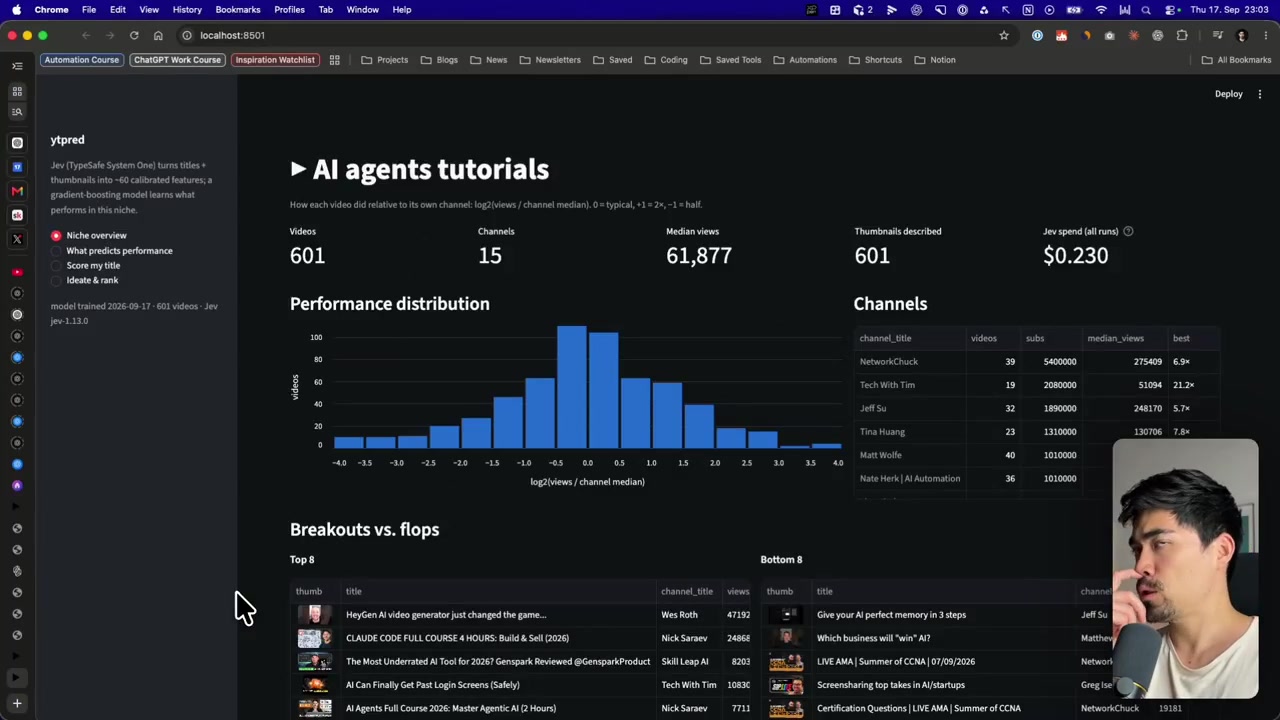
模型对照过基线(留出频道测的):只看频道均值,斯皮尔曼相关是负的;TF-IDF 标题特征 0.186;Jev 特征加代码特征 0.349,是最终上线的版本。特征重要性排在前排的包括:视频时长、是否直播或活动、频道订阅数、是否课程或培训、封面是否直接展示结果。
09 打分与构思:正例、反例、十五个候选
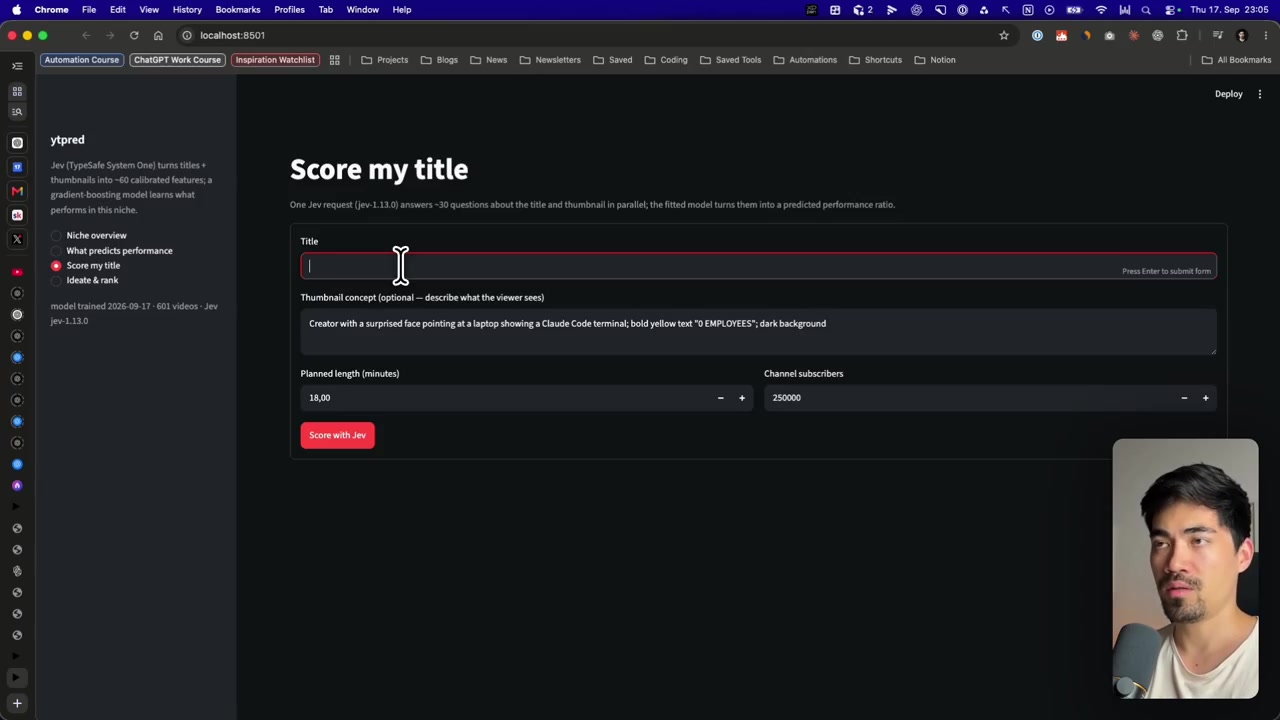
真正常用的是「给我的标题打分」。输入四样:标题、封面概念描述、预计时长、频道订阅数;一次 Jev 请求答约 30 道题,返回一个相对频道中位播放量的倍数预测,外加一个 Jev 直觉分和一份「帮忙还是拖后腿」的特征清单。
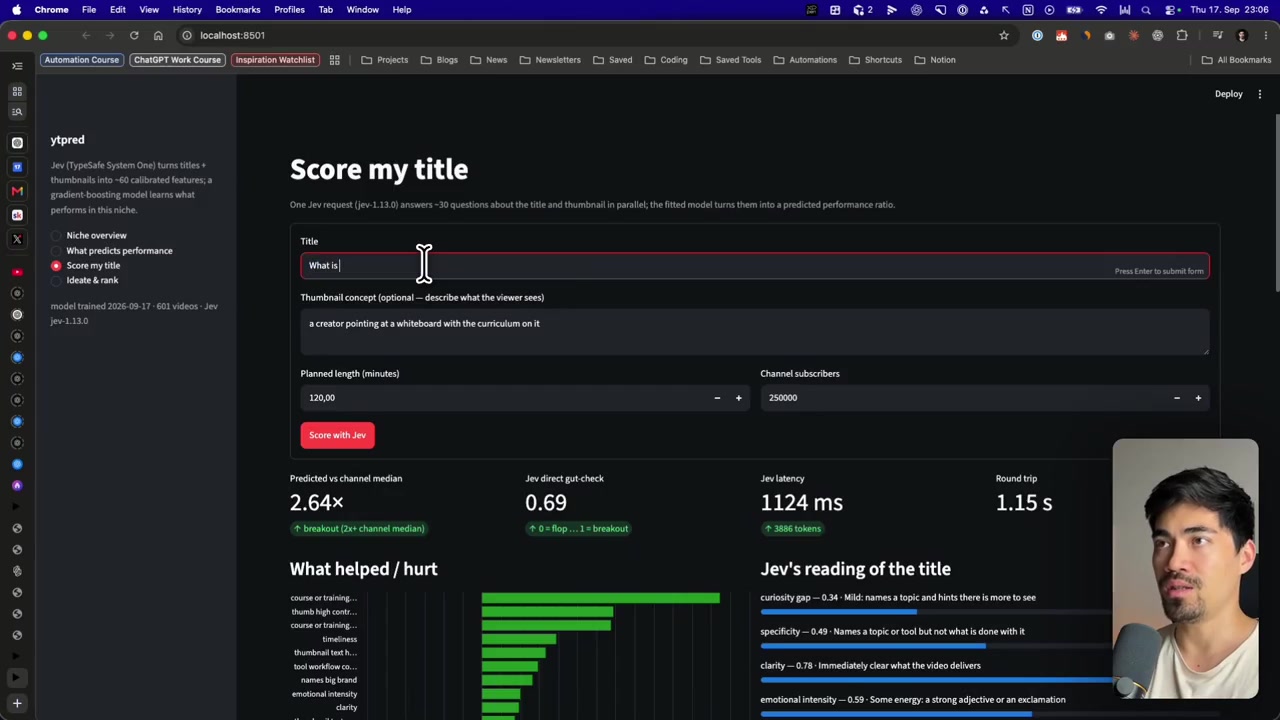
正例是他真在做的课程视频:标题「The only ChatGPT work and Codex course you need in 2026」,白板课程封面、时长 120 分钟——预测 2.64 倍频道中位(两倍以上判为爆款),直觉分 0.69;帮忙的特征里有课程或培训、清晰度 0.78、情绪强度 0.59。反例换成一个泛泛的「What is Jev?」,配「Jev is insane」封面、20 分钟——预测 0.35 倍、直觉分 0.16,连频道中位都够不着;拖后腿的是清晰度 0.34(读者得猜这视频讲什么)、具体度 0.36、受众层级不明。同一个工具,两次输入,读数摆在一起就是一份可复查的判断依据。
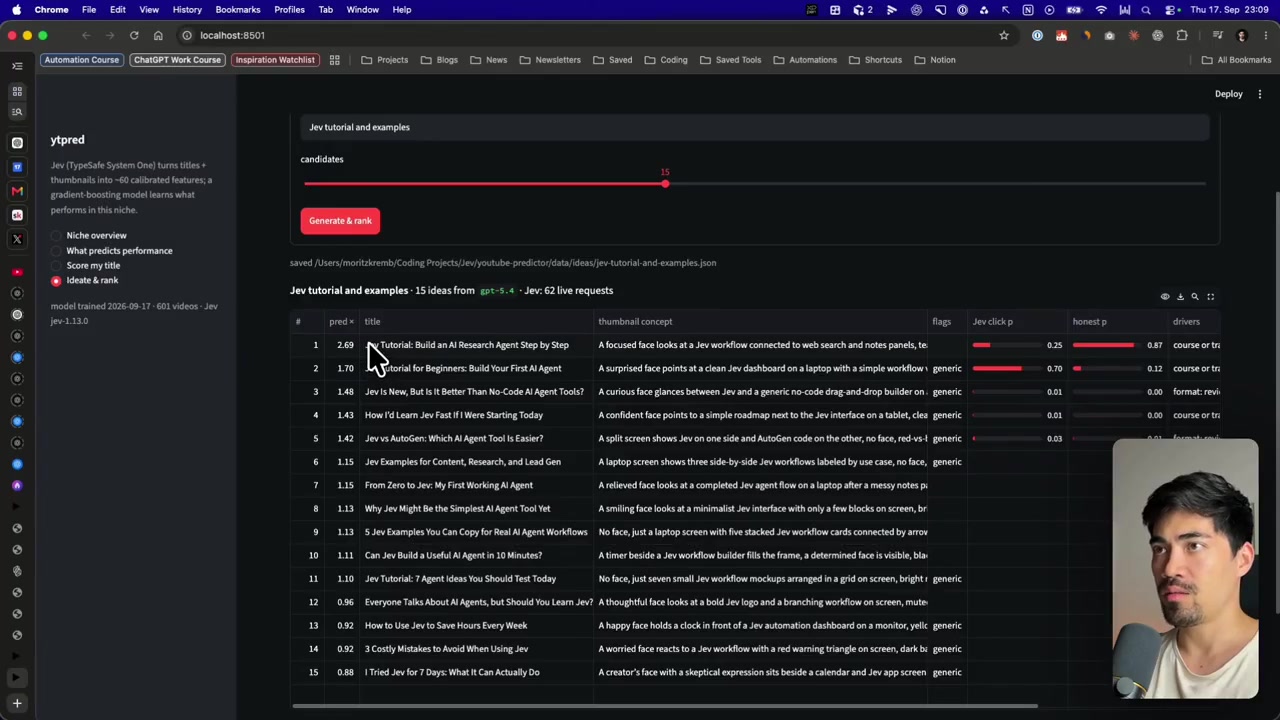
「构思」功能再往前走一步,流程写着:生成、特征化、排序、合理性校验。输入下期选题,LLM(画面显示是 gpt-5.4)一次生成 15 个候选标题和封面概念,Jev 用 62 次实时请求逐个打分排序,另给「点击分」和「诚实分」两列。排第一的是「Tutorial: Build an AI Research Agent Step by Step」,预测 2.69 倍,点击分 0.25、诚实分 0.87;第二才是「Jev Tutorial for Beginners: Build Your First AI Agent」,1.70 倍,点击分 0.70、诚实分 0.12;垫底的第 15 名是「I Tried Jev for 7 Days: What It Can Actually Do」,0.88 倍。演示者直说不完全认同这个排序——影响点击率的变量太多;他自己最常用的,是打分那个标签页。
10 收进工具箱:今天就能做的三件事
回头看,三条提示词有个共同结构:先让 AI 摸清上下文(读文档、看文件夹、抓赛道数据),再动手搭,而且都要求把「之前怎样、现在怎样」做成可对比的界面。这个结构比任何一条具体提示词都值得抄。
能力边界再压一遍:Jev 不写句子、不解释、不写代码、不做逐步推理,单独成不了事;它的位置是 Agent 主循环里那个每秒被调用多次的判断件,生成和深推理仍归 LLM。「快 100 倍」是厂商口径,但 9 道题 0.0002 美元、601 条视频 0.23 美元这些单价,是画面上实打实的。
今天就能做的三件事:
- 去 typesafe.ai 排上候补名单;进不去也不影响下面两件。
- 把语音项目那六道判断题抄下来,对着自己的高频判断改一版——你的系统里哪些决策能压成固定选项加阈值?
- 拿记忆系统那条提示词套自己的笔记库或文档库,让 AI 先量出旧法的命中率和 token 成本,再谈改进。
跑通的标志不是它多快,而是:一个判断在几百毫秒内回来、带着概率、你的规则代码能按阈值分支,并且「不知道」也能作为一个正面答案返回。
原作者:Moritz Kremb(@moritzkremb),实操演示视频发布于 X。