用 AI 视频工具做短片的人,多半撞过同一堵墙:单个镜头能生成得像模像样,一旦要连成一段有角色、有连续动作的戏,风格接不住、动作对不上,返工比重做还费时间。动画师 Amina 在 Higgsfield Animation 频道第一期节目里,用一部正在制作中的五分钟动作喜剧短片《Passport Rush》的出租车追逐段落,把团队怎么把 AI 塞进传统动画流程交了个底:这场戏 18 个镜头,3 天做完。
视频全长 28 分 05 秒,由 X 账号「小互」搬运发布;主讲人 Amina 与团队都是传统动画出身,加入 Higgsfield 之前没碰过 AI。本文的事实按视频画面逐帧核过(素材自带的 57 张截图,全部与原视频对应时间帧逐帧核对一致),并订正了两处转写走样:频道名是 Higgsfield Animation,不是转写稿里的「Hixfield」;给出租车做「撕掉车顶」编辑的图像模型是 Seedream 5.0 Pro,不是「SeaDream」。全文带走四样东西:一条 asset-first 原则、一套从角色表到视频生成的完整工作流、5 模块视频 Prompt 的写法、3 条前期测试教训——外加一个他们至今没跑通的镜头,和它背后的「表演差距」。
01 前期:故事板只保留故事节拍
前期流程和传统动画没有区别:创意、剧本、故事板。这一段要测的题也明确——Blender 的 3D 预演(previs)和 AI 视频生成,能不能合起来做动作戏。喜剧方向定在视觉层面:让出租车的动作跳跃、不可预测,做出真实车辆做不到的事。团队小,人身兼数职,没有专职提示词工程师——角色、场景、动画各部门的艺术家自己写 prompt。
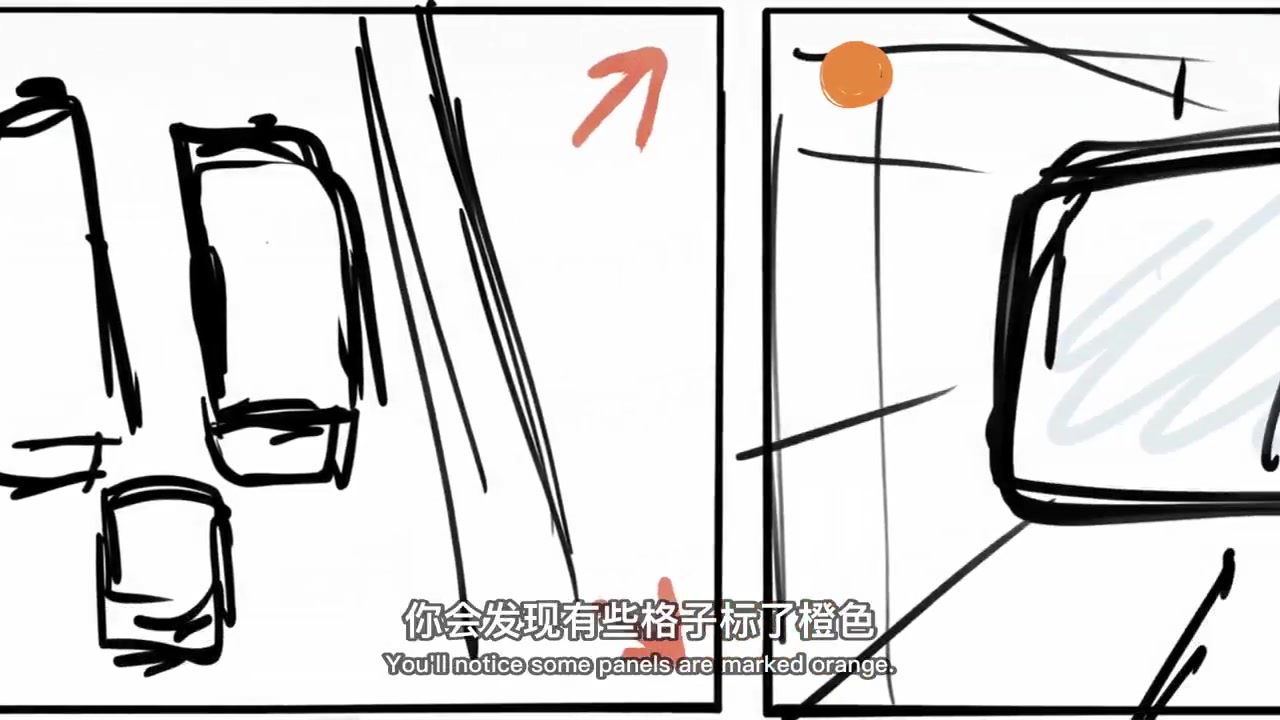
故事板上有个关键约定:标橙色的镜头先过 Blender 做预演,留白的直接进视频生成。分工逻辑是——动作复杂、运镜特殊、用文字很难跟模型讲清楚的,交给 Blender;简单镜头直接文生视频。还有一条容易被忽视的克制:故事板只是参考,不是铁板钉钉。AI 视频生成结果不可控,所以他们只保留「故事节拍+主场景」,不逐镜头规划,给即兴留空间。
02 Asset-first:图像输入决定成片质量
整条管线围绕一条原则搭建,团队叫它 asset-first:图像输入的质量决定成片质量。输入含糊、马虎、前后不一致,整部片子就糙。图像输入指的是角色设定表、道具设定表、场景背景图。为此项目专设一个岗位「资产管理员」(Asset Manager),职责是确保角色、道具、场景在视觉上属于同一部片、同一个世界——屏幕原话是 makes sure the assets fit into the same film and world,干的就是传统流程里美术总监的活。
平台侧的组织方式能对上:Higgsfield 的 Cinema Studio 里,《Passport Rush》项目按 Locations、Taxi driver、The girl 分资产夹,后来做撕顶版本时再单开一个 Roofless taxi 夹。美术方向则是自找难题:风格化 3D 角色搭配水彩背景——这两种风格在传统流程里就很难协调,团队把它当成这部片要过的关。角色设计目标是可爱、搞笑,身体比例要撑得起夸张动作;项目周期紧,常常只有一个月就要开机。
03 主角:Claude 写角色表,Soul 2.0 出图
角色设计从一份提示词开始。流程是:把一段简短的需求描述交给 Claude(换成任何 AI 聊天工具都行),它输出一份完整角色表 prompt——外貌、服装、姿势、构图、打光全覆盖。
生成之前必须逐条核对,把与设计意图不符的细节改掉,因为措辞直接决定出图。屏幕上那份女孩角色表写得极细:铜红色长发、米白色无线耳罩式耳机、宽松的灰蓝色拉链卫衣、卡其百褶短裙、过膝的米色罗纹袜、帆布低帮鞋——耳机明明白白写在设定表里,这个细节后面还会翻出来一次。
出图用 Higgsfield 自研的图像模型 Soul 2.0,本项目全部视觉资产都由它生成。模型由创意部与工程部联合开发,团队背景横跨电影、动画、摄影、时尚与平面设计,主打的就是视觉品味与画质。操作在 Cinema Studio 里完成:选定模型、粘贴 prompt、设好画幅比例、一次生成四张。
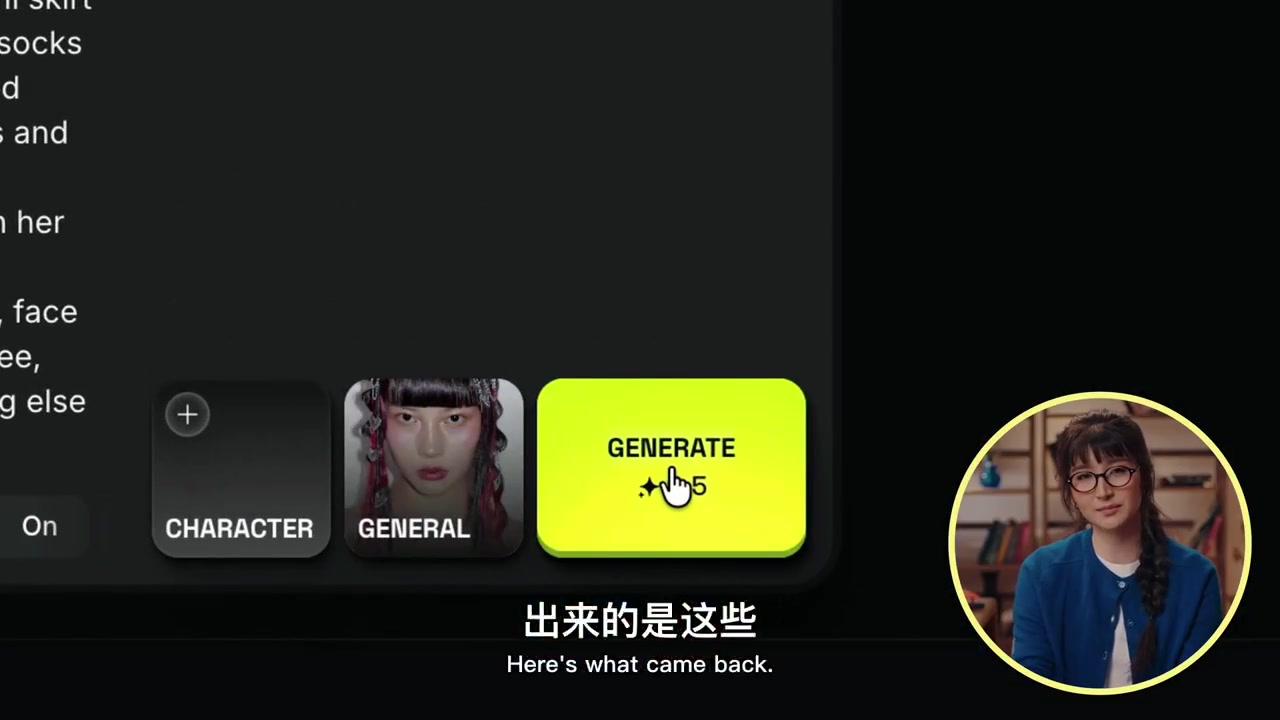
首轮四张逐一过堂:第一张感觉对但表情太傻气,发型和服装不到位,主角不够突出;第二张讨喜却过于写实,不合影片风格,需要更有表现力的脸和更夸张的比例;第三张的姜红发色在水彩背景上非常醒目,但比例仍欠佳,着装也太正式——赶飞机的人套条运动裤才对。
第四张入选:保留第一张的卫衣和运动鞋,加短裙强化轮廓,姜红头发配蓝帽衫的对比正是想要的。
04 手工收尾:提亮、手绘笔触,两个角色同一部片
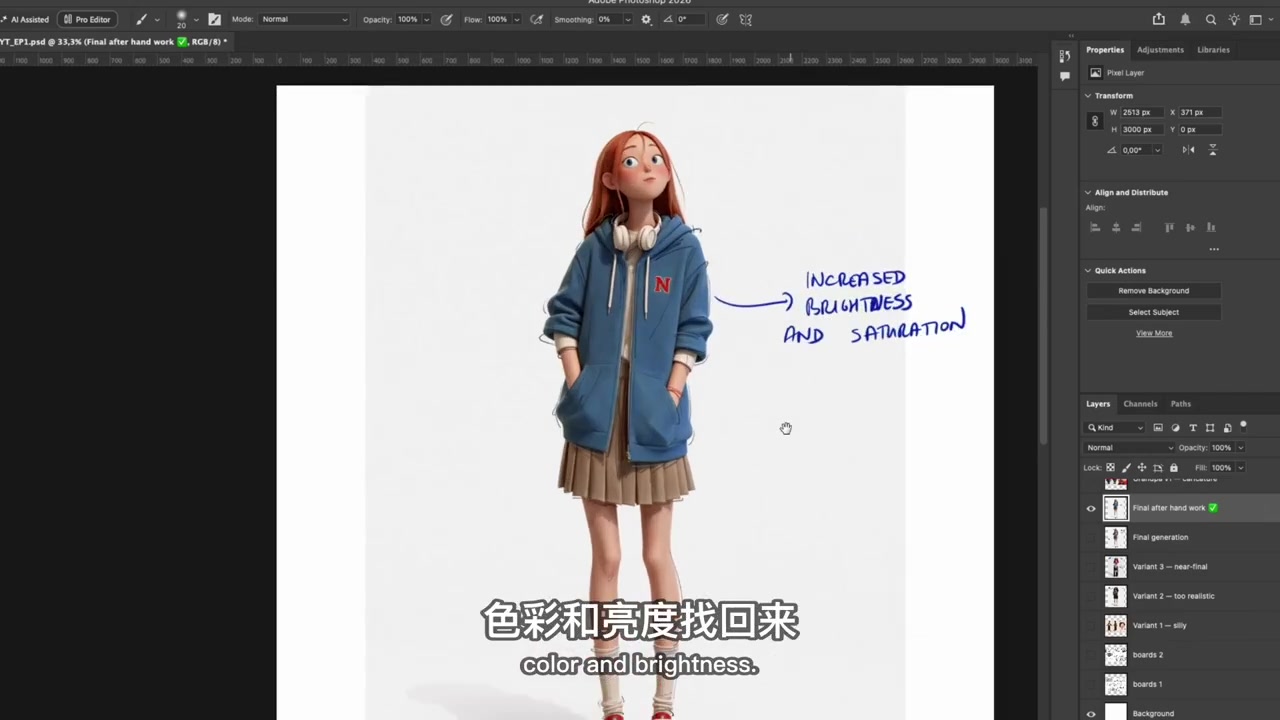
生成只是半成品。色板偏灰偏暗,撑不起喜剧调性,先在 Photoshop 里把亮度与饱和度拉回来(画面注记就写着 INCREASED BRIGHTNESS AND SATURATION),再沿角色轮廓添加手绘笔触:主体仍是 3D,细节叠上手绘,做出 3D 与 2D 融合的手绘动感。
配角出租车司机走同一套流程:Claude 写需求,Soul 2.0 出图。中间版本各有毛病——脸颊过于红润、发型在几个视角里各长各样、皮肤和胡子塑料感太重、神情疲惫焦虑(而他马上要载着姑娘横冲直撞,人设得是从容)。最终版是棒球帽配大胡子,友善、自得其乐——用主讲人的话说,他招手你就会上车,但大概只敢坐一次。同样加上手绘笔触之后,两个角色看起来属于同一部片。
05 场景:水彩差点被放弃
场景是整个项目落地最难、教训最多的部分。最初的设想是纯水彩,但测试出来画面潦草、脏乱、没有重点;团队一度认真讨论过放弃水彩、把全片推向更纯粹的 3D。最后没有放弃,而是两个方向同时测,在水彩与 3D 之间找自己的平衡。这段弯路他们自己给了解释:找到正确方向之前就是得犯足够多的错,没被采用的方案也帮忙排除了选项,让美术方向更早定下来。
另一个翻盘点是时间。片子最初设定在正午,画面扁平沉闷;改成午后黄金时段的光线后,体积感和纵深感都出来了。整部片的视觉公式就此定型:先用 prompt 生成水彩风格的场景,再在后续制作里通过提示词加黄金时段光照。
由此还有一条流程结论:资产要尽早放进视频里测。传统流程里前期做动画测试是测角色,这条 AI 流程里背景也能一起测——背景常常以意想不到的方式反作用于场景,比如那辆出租车。
06 出租车:能当主角,不能太「水彩」
出租车贯穿全片,被当成一个有性格的独立角色来设计。最早的 3D 测试就是让它跑在路上,动画师借机探索它的运动方式:跳跃感要强、要有挤压拉伸,还要呼应车主的性格,接近骑手与坐骑的关系。凡是有它的镜头都先做 3D 预演、再作为视频输入进制作——运动方式已经明确时,直接做动画比在提示词里逐字描述高效得多,何况他们本来就是视觉艺术家。
麻烦出在纹理上。为了融进水彩世界,车身叠了厚重的水彩纹理;但在视频里,纹理贴在 3D 形体上的方式显得廉价,像一张 PNG 被硬拉伸罩在几何体上。多次尝试后他们给出的诊断是:水彩道具压在水彩背景上,两层高密度纹理在每一帧里打架。解法是做减法——车回归干净 3D,水彩交给它所处的世界。
那辆车当时的请求词很短:一张老式黄色出租车的水彩画、3/4 左前视角、画面里只有一辆车、浓郁水彩晕染带滴痕和高光、车下柔和阴影——
交给 Claude 扩成完整的道具表 prompt,再放进 Soul 2.0 里跑;道具表细到车牌号、车门上圆形的 T 字徽章都写死。车型定稿后还要一个「车顶被撕掉」的版本:这次不从头生成,而是编辑已有图像,工具换到 Seedream 5.0 Pro(画面字幕与模型选择器都写明是它);编辑提示词要求「把上半截暴力撕掉、做出撕裂残骸感、不是干净的切口」,末尾还专门加了一句「不要出现人」。后座内部视角同样用编辑工作流,把主车设计挂为参考。
07 其他道具与特效:只给反复出场的东西做设定表
其余道具走快速通道:一闪而过的卡车保留水彩直接生成,不做设定表;只有跨场景反复出现、需要保持一致的道具才值得做——比如持续出镜的三辆卡车。片尾的爆炸特效也做了特效表,这段几乎是提示词用词的教科书案例:最初写「蘑菇状爆炸」,模型老老实实生成了字面意义的蘑菇形烟雾;改成「核爆」大体解决,但还不够风格化——最后的办法是在生成结果上手工叠手绘纹理,把玩味拉回全片的美术方向,这一版保留进了成片。
08 视频 Prompt 前两块:场景上下文与活动参考
资产锁定后进入制作:以资产图为输入文生视频做常规镜头,复杂镜头加预演阶段。到这一步,成败压在视频 prompt 的写法上——凡是没写的细节,模型都会替你决定,而且猜得很差,主讲人的原话是「它是个糟糕透顶的猜手」。所以一个四秒的镜头,他们写一篇小论文。顺序本身就是规则:模型和人一样从上往下读,提示词开头的前 20% 权重最高(屏幕标注原文是 first 20% of the prompt matters a lot),越往后遵循越松。
第一块,场景上下文与风格:用平实的句子交代镜头里发生什么,写明风格规则和世界物理。屏幕上那份真实 prompt 的开头长这样(示例取自影片另一组无顶出租车与交警的镜头):
STYLIZED 3D ANIMATED FILM SEQUENCE, slapstick action comedy from "PASSPORT RUSH" (taxi chase). … animation ON TWOS (every key pose held exactly 2 frames, stepped pose-to-pose, no mushy interpolation), FULL 12 PRINCIPLES applied… Total 6s: Shot 1 = 3s, Shot 2 = 3s.
连「每两帧一拍、十二原则全用」都写死在风格块里。
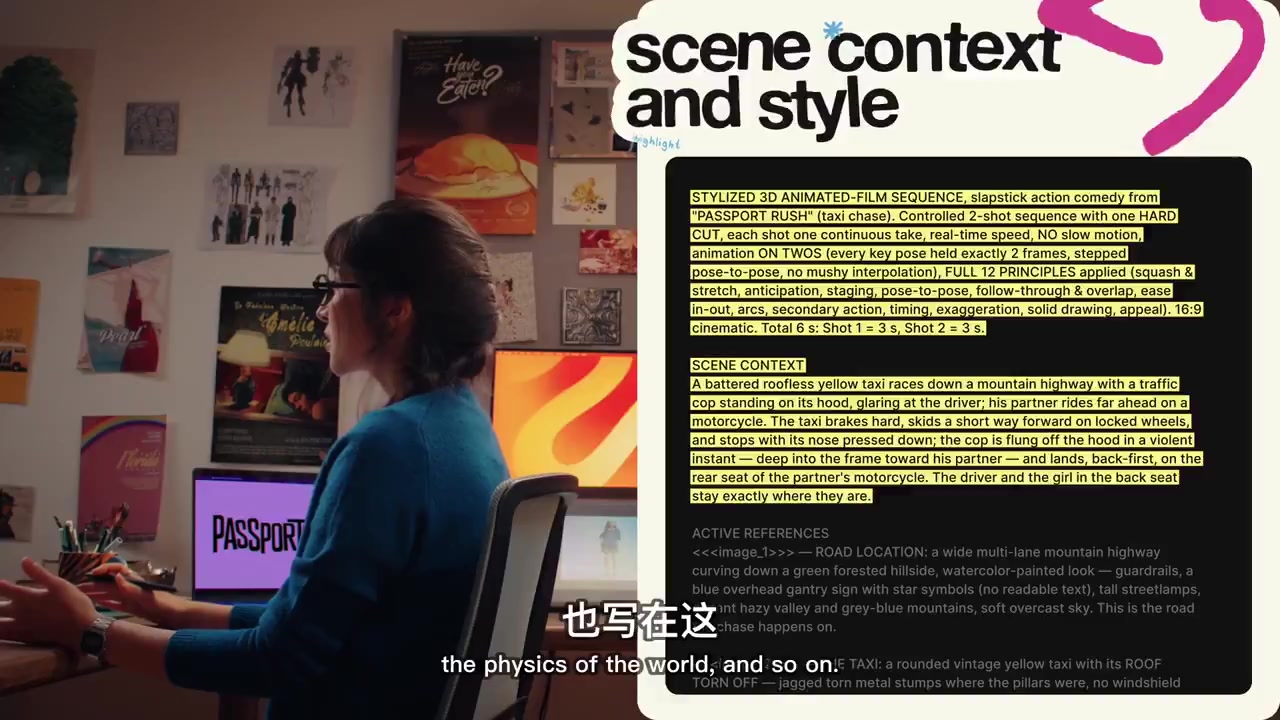
第二块,活动参考(Active References):场景里用到的资产以附加图片或视频形式引入,像一份通告单,逐项标明每张参考是什么——不标,模型又开始猜。这块里可以写角色的性格、资产的质感,但不写视觉外观,外观由图像输入负责;并且每次都加一行 Characters, environments and props 100% match the reference.(角色、环境、道具与参考百分之百一致)。屏幕示例里,每个参考占位符后面都跟着一段用途说明,再补一句 100% matches the reference。
09 视频 Prompt 后三块:镜头结构、约束、动画原则
第三块,镜头结构:按硬切划分镜头,逐节拍描述动作与时间——先发生什么、接着是什么、每个动作持续多久。本质上是文字版的故事板。
第四块,规则与约束(locks & constraints):视频模型热衷于自作主张,约束的作用是把它拉回正轨。具体条目因项目而异,他们雷打不动保留的一条是「无音乐、只留画内声」(幻灯片原文 No music — diegetic sound only,另外还写了 no subtitles),这样后期配乐和音效才有干净的处理空间。
第五块,动画原则:把十二项动画原则里的挤压拉伸、预备动作、跟随动作等全部写进去。模型不会每次都全部遵循,但写进去,运动就更接近预期。
这套结构不必每次手写:交给 Claude 固化一次,之后每条 prompt 自动沿用——他们称之为 skill,也就是系统提示。团队共享同一套系统提示,所以每个人写出来的结构都大差不差。
10 实战全链:出租车挤过两辆卡车
拿一个镜头走完整链条。故事板:出租车驶向两辆卡车之间的缝隙,侧倾到只剩两轮着地,从缝隙里挤过去,脱离卡车后落回四轮。速度这么快的动作,顺序必须一眼看清——接近、倾斜、挤过、落地,一拍不能乱。
然后在 Blender 里推演动作,这是动画师最享受的部分:反复调整开始倾斜的时机、两轮着地保持多久、落地怎么收尾;镜头跟着动作同步调,来回播放微调。导出的灰色预览不带颜色和材质,只负责呈现运动与构图——最终长什么样,交给后面的图像参考。
到 Higgsfield 里组装:灰色预览作为视频输入上传,再分别挂上出租车、两辆卡车、角色、道路、光线的图像参考。提示词由 Claude 协助撰写,描述动作、并逐一说明每张参考的用途——视频参考引导运动与镜头,图像参考决定最终外观。再加细节约束:两名角色全程留在座位上;出租车必须完全越过两辆卡车之后才能落地,否则模型会让它一直刹车。
生成之后是验收:与预演逐一对照回放,检查节奏、镜头、车辆与角色是否还贴合原始设计——这一次,全部一致。
11 测试阶段与三条教训
这些做法不是先想好的。前期与正式制作之间,团队专门设了一个测试阶段(幻灯片标题就叫 Test early):把做好的资产直接丢进视频模型,验证它们能不能用于最终镜头——问题越早暴露越好,拖到制作中途返工,代价大得多。项目最初的视觉规则,就是从三组测试里沉淀出来的。
教训一,车身纹理量。早期测试确定车身上保留多少水彩纹理,再把这一视觉方向写进提示词,让整段戏里车表面质感一致——否则手绘风格的场景里会突然冒出一辆照片级写实的车。
教训二,空车里会自己长人。角色设定表还没完成时他们就开测了,车里是空的;结果模型总往画面里塞随机路人,参考图和提示词里都没有。把角色参考加上,路人立刻消失。
教训三,光线。一位成员随手在提示词里加了傍晚光线的描述,画面瞬间变暖、纵深感明显增强。低角度暖阳加长阴影从此锁定为全片的光线方向,与测试通过的车辆、角色参考一起带进正式制作。
12 三个多花功夫的镜头
全段 18 个场景,有三个额外费了劲。
镜头一,女孩紧贴卡车门。Blender 里动作参考早就做好了,生成却始终不对。原因很隐蔽:预览镜头离主体太近,去掉贴图和面部细节后,画面里只剩大片灰色色块,周围环境几乎不可见——团队的人对场景烂熟于心,能脑补出每个元素在哪,模型不能,它读不懂角色和物体的空间关系。
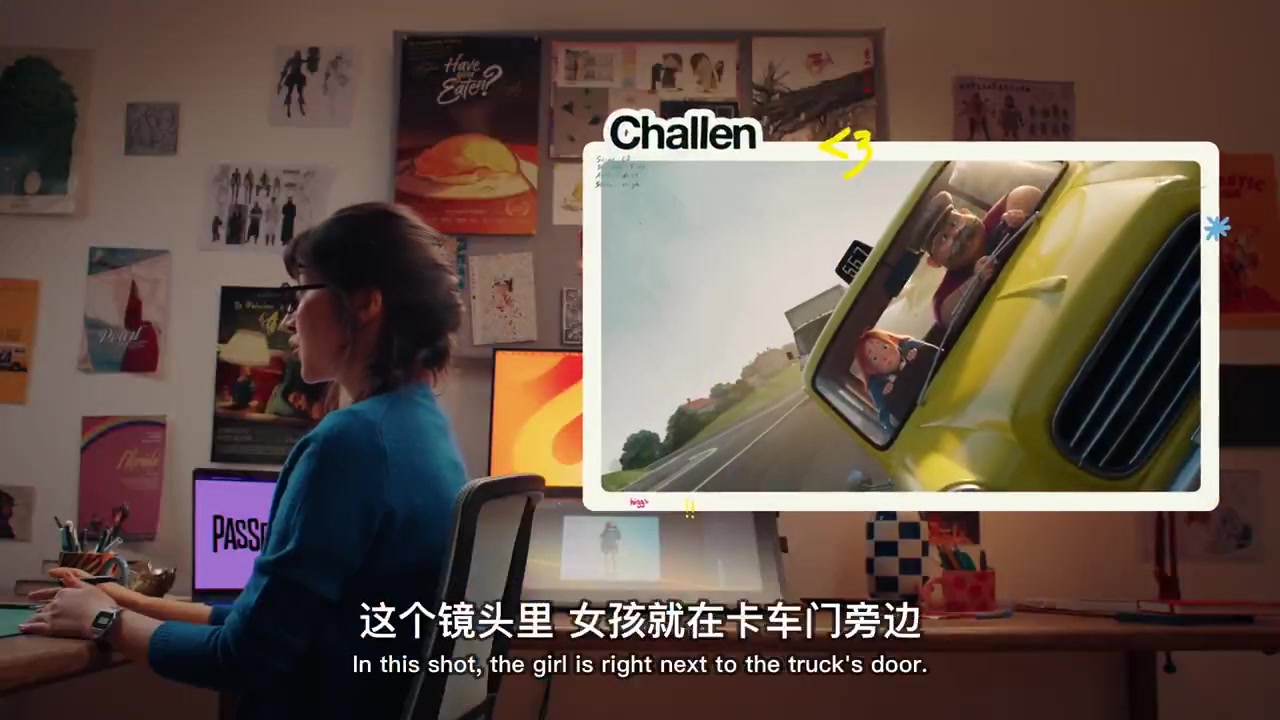
把 Blender 镜头往后拉一点,让更多场景入画,下一次生成就直接通过。由此得出规则一:模型读不懂你的参考,多半是画面里能看到的内容不够——把镜头拉远。
镜头二,女孩系两条安全带在胸前交叉成 X。这个动作早期测试就跑通过;换上角色的最终设计重新生成,镜头角度却在每一条之间不断漂移,想要的构图稳不住。解法是从接近理想机位的成片里截屏,作为下一轮生成的参考,构图这才稳定下来。但新问题跟着来:每一条里她的耳机都不见了。回头看那张截屏——耳机本来就没画进去,挑图时只顾机位,漏了这个细节;而角色设定表里耳机还在,参考与设定表对不上。于是在 Photoshop 里打开那张截图,把耳机手绘补回去再当参考:下一条生成,构图和耳机都在。
镜头三,车顶把手,没跑通,主讲人的个人最爱。设计是个小噱头:慌乱中女孩抓下车顶扶手,扶手被扯断;她惊慌去抓另一个,也掉了。看着故事板以为不难——满街乱飞的木头和爆炸场面都在做,还搞不定两个扶手?实际难点全在细节:两个把手的一致性,装在哪、怎么脱落、被握住是什么样,全都得写清楚,琐碎至极;她的抓握表演也始终稳不住。这个镜头最终没进成片。
13 表演差距:AI 啃不动最简单的戏
车顶把手真正卡住的,不是几何,是一拍停顿。恐慌反应之后,需要有一个瞬间让观众意识到「扶手坏了」,她才会去抓下一个——这一小拍停顿是把笑点托起来的关键,做动画的人都懂。但仅靠文字提示词,始终打不准这几拍。团队转向 Blender,把表演自己先演一遍当视频参考,结果两头堵:用灰色占位人物,生成画面里表情和手部动作传达不出来;给占位人物加细节,模型又开始照抄 Blender 的几何形状,丢掉真正的角色设定表。
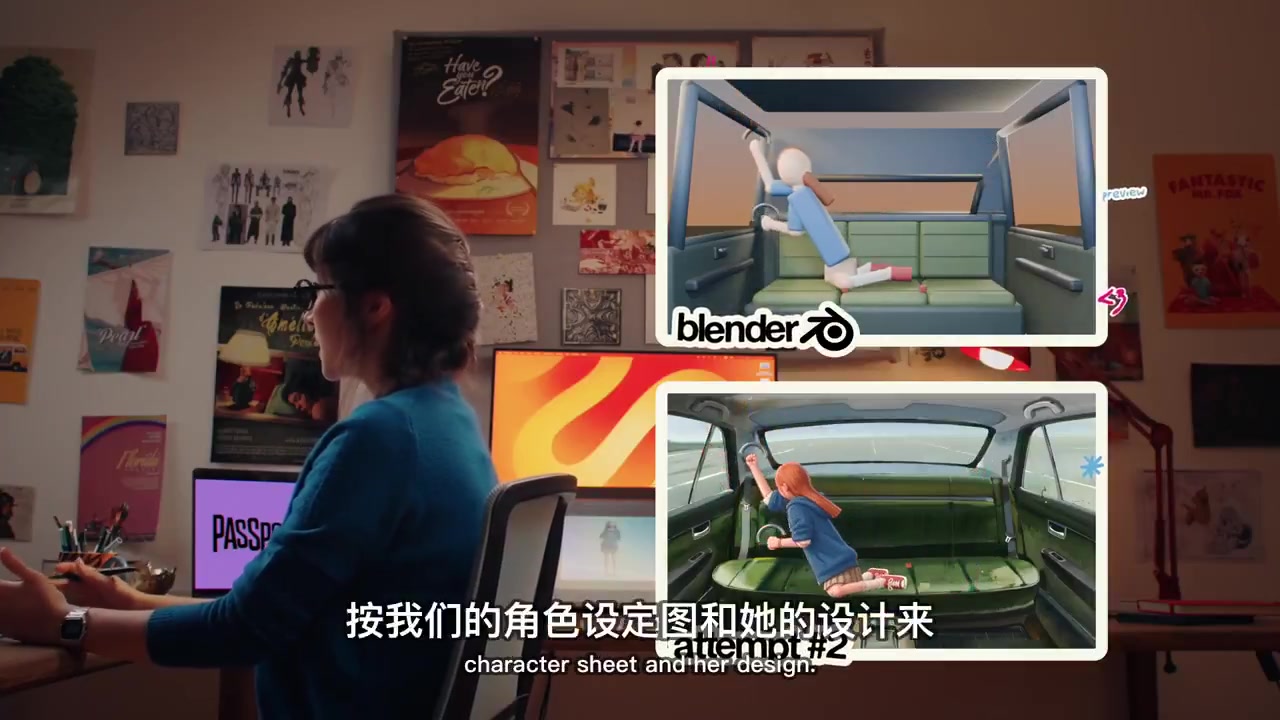
团队给这个现象起了名字:表演差距(performance gap)——知道角色该怎么反应、在哪里停顿,却无法在保持最终角色设计一致的前提下,从 AI 手里拿到这段表演。真正意外的是结论的反转:传统动画里相当好做的镜头,AI 反而最吃力;原以为更难的大场面动作戏,倒是一路做下来了。这些碰壁也帮他们想清楚了下一步该测什么——并不是所有问题都解决了。
14 收尾:3 天 18 镜头,和现在就能抄的三件事
这场追逐戏的最终战绩:18 个镜头,3 天完成。完整短片做完后,团队会发布《Passport Rush》的完整复盘,公开全部制作数据——生成次数、预算、制作周期。
编者判断收个尾。这套流程里最值得抄的不是哪个工具,而是三个决定:把质量押在图像输入而不是生成上(asset-first);让资产在前置阶段就进视频试错(Test early);把「模型会瞎猜」当成默认前提——prompt 里没写的细节,就等于交给了它。它的边界同样诚实:能稳定跑通的是车辆、镜头运动和外观一致性,跑不通的是两拍之间的表演停顿;想做叙事动画的人,手绘板和 Blender 还是省不掉。要启动的话不必从短片开始:挑一个你正在做的四秒镜头,按 5 模块把提示词写满,再跟旧写法各生成一次对比——「它是个糟糕透顶的猜手」这句话,你会立刻有体感。
原作者:Amina(Higgsfield Animation 频道主持人);本文观点出自该频道第一期节目对《Passport Rush》出租车段落的制作拆解(28 分 05 秒),视频由 X 账号「小互」搬运发布。