这支 15 秒的 9:16 竖屏一镜到底不是一段 ASR 撑得起来的视频。梦老湿 Dream AI 在 X(@jackzhang123vip)发的原片里,语音轨只有一句英文开场白「Thank you so much for joining us」,真正撑起画面的是背后那套 800 余字的提示词工程化拆解:把人物按 9 层颗粒度拆开、把镜头按 5 类物理参数写定、把 15 秒切成 5 段 3 秒的时序剧本,再叠加 4 件反 AI 化的微表情约束和 5 条工程化技法。本文按这套技法重新拆一遍,目标是把这一篇当 prompt engineering 的可抄走案例,读完之后,你能拿同一份骨架去改自己写过的、跑出来很「网红」的人像 prompt。
01 9 层人物:把每一层都写成「真实特征 + 明确禁止项」
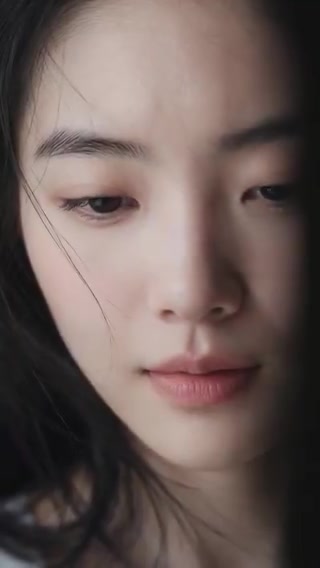
梦老湿这套提示词最值得抄的第一点,是把人物从「一个形容词串」拆成「9 层颗粒度 + 每层都带真实特征与明确禁止项」。9 层依次是:脸型、皮肤、眼睛、眉毛、鼻子、嘴唇、妆容、发型、服装。每一层都不是「好看的」「自然的」这种虚词,而是先写具体可验证的真实特征,再写禁止项。
脸型层写「自然小巧的鹅蛋脸,柔和轮廓,饱满额头,自然收束的下颌线,圆润下巴,柔软体积感面颊」,明确否定「网红尖削脸」——这一句否定项几乎决定整支视频会不会被模型拽向浓妆磨皮的方向。皮肤层写「自然冷白偏中性色调;保留细小毛孔、极细面部绒毛、鼻翼自然纹理、轻微肤色不均与真实明暗过渡」,明确禁止「油腻、反光过度、玻璃肌或塑料感」。眼睛层写「深棕色杏仁眼,柔和眼型,自然微延伸的眼尾,浅双眼皮;真实湿润反光与虹膜放射状纹理;睫毛纤细自然、长度适中、根根分明」,禁止「浓密假睫毛」。唇与妆层写「唇峰柔和、低饱和玫瑰粉唇色、唇纹清晰、轻微湿润感,禁止明显唇釉;薄自然底妆 + 浅米棕眼影 + 极细内眼线 + 淡粉唇妆,接近素颜」。
眉毛层写「自然平直略带弧度的黑眉,眉头毛流清晰,眉尾自然变细并保留少量不规则细节」,明确否定「完全整齐划一或过度修饰的纹眉感」。
鼻子层写「鼻梁挺直、鼻尖小巧圆润、鼻翼窄而真实」,明确否定「过度尖锐的网红鼻型」。
发型层写「浓密乌黑长发自然披散,略带松散波浪弧度,发根蓬松,分缝不完全整齐」,明确禁止「整齐假发质感」。
服装层写「低饱和深灰或灰蓝色柔软针织上衣,领口宽松」,明确禁止「夸张耳环、项链或头饰等配饰」。
应用到 AI 人像 prompt 的具体写法:先把人物按这 9 层写出来,再在每一层末尾加一句「禁止 X」。9 层 × 真实特征 + 禁止项,等于把「网红脸」「塑料感」「美颜写真」这些最容易跑偏的审美方向逐一钉死。模型看到「不是」清单时,对「是什么」的理解会显著收紧。
边界:这套 9 层拆解对「追求电影感真实人像」的 prompt 有效。如果你想要的恰恰是时尚广告感、网红自拍感、商业美颜写真感,禁止项就要反过来,但那就不是这一份提示词骨架的适用场景。
02 5 类镜头参数:把镜头语言物理化
第二点是把镜头语言从形容词写成物理参数,让模型能像接到摄影师 brief 一样执行。整支视频只用了 5 类参数:焦段、光圈、机位距离、构图占比、画幅与帧率。
焦段 85mm 给出电影人像镜头的透视观感(避免广角的畸变、避免长焦的扁平),光圈 f/2.0 给出浅景深(五官清晰、背景柔和虚化)。机位距离 25–40 厘米、面部占据画面 80%–90% 是极近距离特写的硬约束——额头靠近上缘、下巴与颈部被下缘裁切,明确告诉模型这是脸部特写而不是半身像。画幅 9:16 竖屏 4K 24fps 一镜到底,把视频规格钉成「现代手机直出的电影感竖屏」而不是「横向 16:9 电影」。
文案上各自带「禁止动作」:镜头全程基本固定,禁止拉远、旋转、切换机位或突变焦距,仅允许极其细微、接近真实摄影机呼吸感的自然运动。这一条把「AI 喜欢乱推镜」的常见毛病一并堵死。
应用到 AI 视频 prompt 的具体写法:把焦段 / 光圈 / 机位距离 / 构图占比 / 画幅帧率五项写进 prompt 头部。每项都用真实摄影师的语言词汇(不是「电影感」这种泛词),并在最末加一句「镜头全程基本固定,禁止 X、Y、Z」。
边界:5 类参数对「超写实人像特写」成立。如果你要做的是远景人物 + 大场景,构图占比 80%–90% 与 25–40cm 机位距离需要全部替换——这一份提示词不能直接套用。
03 5 段动作剧本:15 秒切成 5 段 3 秒
第三点是时序化的动作剧本,把 15 秒切成 5 段 3 秒,每段写「动作主体 + 幅度量级 + 面部参与肌肉 + 禁止动作」。
第一段 0–3 秒「睁眼起手」:双眼自然轻闭 → 缓慢睁开 → 深棕色瞳孔逐渐露出,目光落在镜头附近;嘴唇轻闭,表情安静。第二段 3–6 秒「视线下移」:眼球自然下转,上眼睑随之下移;头部仅极小角度下倾,脸颊、鼻梁光影产生细微变化;嘴角自然放松,黑色碎发轻微移动。第三段 6–9 秒「低头思考」:人物继续低头凝视画面下方,若有所思;嘴唇缓慢微张约 1–2 毫米以呈现真实呼吸感,禁止说话或夸张口型;睫毛轻微颤动,面颊肌肉出现极细微的放松变化。第四段 9–12 秒「回视镜头」:缓慢抬起眼睛,目光从下方回到镜头附近,眼神温柔、安静且若有所思;嘴唇从微张状态自然恢复轻闭;完成一次自然缓慢的完整眨眼。第五段 12–15 秒「微侧收尾」:目光短暂转向画面右侧,再缓慢回到镜头附近;头部极轻微侧向调整,几缕发丝随动;嘴角几乎不可察觉地轻微上扬,不露齿、不夸张;最后一秒安静凝视镜头,眼睛湿润明亮,呼吸自然。
应用到 AI 视频 prompt 的具体写法:把总时长切成 5 段左右,每段 3–5 秒,逐段写「动作主体 + 幅度量级(mm / 度)+ 面部参与肌肉 + 禁止动作」。幅度量级写毫米级和度级,模型才知道什么是「自然微动」、什么是「AI 跑出来的诡异表情」。
边界:5 段切分对「单人特写 + 单一场景」成立。如果是多人物、多场景切换的视频,每段 3 秒的约束需要放宽,且每段要重新起一个「动作主体 + 场景 + 镜头」的完整 brief。
04 反 AI 化的 4 件微表情约束
第四点是反 AI 化的微表情约束——把「不要 AI 化」这一模糊目标,拆成 4 个具体可验证的微表情控制点。
眼球与虹膜:平滑转动,虹膜大小稳定,眨眼时上眼睑自然闭合与睁开,禁止机械感。嘴唇:微张时保持真实唇纹,禁止嘴部变形。呼吸:只产生极轻微的面部与肩颈变化,禁止明显起伏或刻意感。皮肤与光影:毛孔、绒毛、肤色不均、鼻翼纹理缺一不可,并需与光照方向自洽,这一条尤其重要,因为 AI 视频最常见的破绽就是皮肤纹理反光方向与叙事光源对不上。
应用到 AI 视频 prompt 的具体写法:把「不要 AI 化」翻译成 4 条「自然特征 + 禁止动作」。这一段通常是 prompt 末尾的 realness checklist——模型在长镜头里会逐渐偏离真实感,把这 4 条钉在末尾能显著降低跑偏率。
边界:4 件约束对「超写实人像 / 自然纪录片风」成立。如果是动画、二次元、卡通风格,4 件约束反而会拖累模型,那就要换成风格化的反 AI 化清单(线条一致性、色块不溢出等)。
05 5 条工程化技法小结:拿这篇当 prompt engineering 模板可抄走
把上面四节提炼为可独立抄走的 5 条工程化技法——这一节也对应把这条 prompt 当学习案例拆完之后我真正带走的可数材料。
第一条负面锚定,反复用「不是 X、不是 Y、不是 Z」排除审美方向(时尚广告 / 网红脸 / 美颜写真),把「不要什么」写在前面可以显著降低跑偏率。第二条颗粒度分层,把人物拆为脸型 / 皮肤 / 眼睛 / 眉毛 / 鼻子 / 嘴唇 / 妆容 / 发型 / 服装九层,逐层写「真实特征 + 明确禁止项」。第三条时序化的动作剧本,将 15 秒切成 5 个 3 秒段,每段给出「动作主体 + 幅度量级 + 面部参与肌肉 + 禁止动作」,便于模型按时间窗口稳定生成。第四条镜头与光线的物理参数化,机位角度、镜头焦段(85mm)、光圈(f/2.0)、距离(25–40cm)、构图占比(80–90%)、窗户方向(人物右前方)、色温倾向(冷调),接近实拍摄影师的 brief。第五条realness checklist,用条目化的微表情控制清单作为最后兜底,防止模型在长镜头中逐渐「AI 化」。
今天就能跑的第一步:拿你自己写过的、跑出来很「网红」的一支人像 prompt,按这 5 条逐条改一遍——先在画面描述头部加一段「不是 X、不是 Y」的否定锚,再把人物按 9 层拆开写(每层带禁止项);如果跑出来仍有 AI 化的痕迹,把动作切 3 秒一段、每段写幅度量级与禁止动作;镜头前一次检查五项物理参数是否到位;最后在末尾加一条 4 件 realness checklist。改完再跑一遍,对比效果,这 5 条就是可独立拿走的可数材料。
最后一条边界:本文 9 层人物 5 类参数 5 段动作 4 件微表情 5 条技法,全部按梦老湿 Dream AI 在 X 发布的 15 秒 Grok Bot 直出视频(口播仅一句「Thank you so much for joining us」,所有工程化内容均在提示词文本内)的提示词原文取,不外推视频之外的事实(如其他电影人像 prompt、其他 AI 视频工具的具体打法、梦老湿的其他教程)。没有真实工程实践 的读者请先把提示词逐字复制到 Grok Bot 跑一次再判断效果,本文不替代实跑验证。
原作者:梦老湿 Dream AI(X @jackzhang123vip);本文转写自其 15 秒 Grok Bot 直出超写实电影人像视频(https://x.com/jackzhang123vip/status/2111238259799904370?s=46),所有 9 层人物 / 5 类参数 / 5 段动作 / 4 件微表情 / 5 条技法均按提示词原文取。