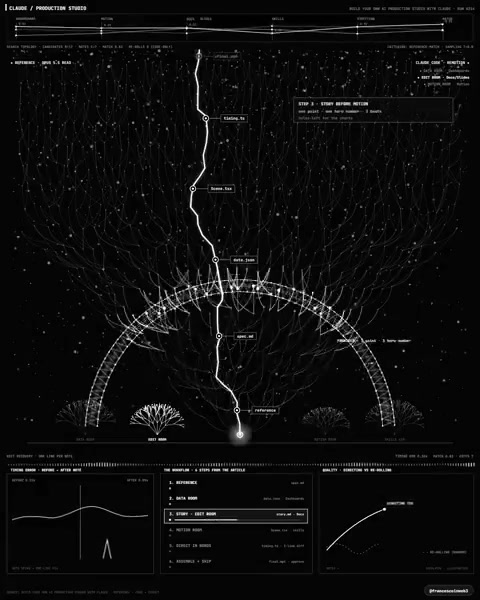
用 Claude 生成视频,干净、流畅、不出错——但也毫无记忆点,看起来和别人的作品一模一样。Francesco 把这个问题的根源讲得很直白:只丢一句"帮我做个关于 X 的视频",然后碰运气。他现在每条视频都走同一套 6 步流程:reference → data → story → motion → direct → ship。
01 Reference(参考)—— 先拆解一段自己喜欢的视频
Francesco 给 Claude 的第一条指令不是"帮我做",而是"帮我看"。给 Claude 一段自己真正喜欢的视频,让它拆解为什么有效:节奏感、第一个动作落在哪里、文字如何进入画面、剪辑的呼吸频率。这一步直接解决大多数"看起来很普通"的问题。
应用场景:剪辑师接到新项目、播客主想做一段二创、内部培训要重新混剪素材时,都适合先做这一步。核心判断:挑出的参考视频必须是你真心欣赏的,不是"行业里大家都在抄"的那种——参考视频的水平锚点会直接决定 Claude 后续每一步的输出天花板。
边界:这一步不会替你做完视频,它只给你一个水平锚点。如果最终输出不需要对标你欣赏的视频,参考视频可以跳过;如果视频要进入一个同质化严重的赛道(AI 教程、产品演示、入门指南),这一步直接决定能否脱颖而出。
02 Data(数据)—— 每一个数字都要有来源
Francesco 在画面动起来之前先准备真实数据。每一个数字都要有来源:一个错误的数字配上一段精美的动画,依然是错的——只是看起来更让人信以为真。
应用场景:科普视频、产品介绍、数据可视化是这条规则的主战场。核心判断:当你准备把数据交给 Claude 时,先问一句"这个数字我能引到一手来源吗"——能引到的数据才进视频,引不到的要么换数字、要么加 caveat。
边界:创作型视频(叙事短片、剧情动画、抽象艺术)没有"数据"这一层,第 2 步不适用。强行给叙事视频编造数字,反而会让画面看起来像伪科学纪录片。
03 Story(故事)—— 一个观点、一个英雄数字、三个节拍
Francesco 把文案放在动效之前。一个核心观点、一个英雄数字、三个节拍:先写文案,再做动效——这样视频才真正"在讲一件事"。
应用场景:商业解说、教程讲解、品牌故事都依赖这条规则。核心判断:一个核心观点 + 一个英雄数字 + 三个节拍(开场、转折、收束)是 30 秒到 2 分钟视频最稳的结构。超过 3 分钟的视频需要拆成多个「核心观点」,每个观点自成一个 3 节奏单元。
边界:第 3 步只解决"视频在讲什么",不解决"视频好不好看"。视觉风格、配色、字体、动效速度都归第 4 步管,把这两件事混在一起做会让文案与动效互相牵制。
04 Motion(动效)—— 把动画写成代码而不是视频模型
Francesco 让 Claude 搭配 Remotion 和一个动效设计技能,把动画写成代码:不调用视频生成模型,因此每一个文字、数字、时间点都仍然可编辑。
应用场景:讲解类视频、UI 演示、图表动画、数据可视化。核心判断:当你的视频需要在交付后继续微调(改一个数字、改一行文案、调一下节奏),代码化的动效让每处修改只要改一行就行;视频生成模型产出的视频里,改一个数字就要重抽整段。
边界:情感类、人物类、抽象艺术类视频不适合代码化动效。人脸表情、肢体动作、手写字迹这类细腻变化仍是视频生成模型的强项。当你的视频核心是"一个人或一个物体的真实表现"时,第 4 步应该用视频生成模型而不是代码化动效。
05 Direct(导演式微调)—— 不重新生成,直接说哪里不对
Francesco 不重新生成,而是直接说哪里不对:「标题晚了一拍」——改一行就行;「这条线画慢一点」——改一行就行。其他内容不会被破坏。
应用场景:所有代码化动效的视频,也就是第 4 步用 Remotion 的视频。核心判断:当你看到视频里有一处想改、但不改也能凑合过去时,直接说"这里不对、应该改成 X"比"再生成一遍"更快更稳。代码化动效允许"小步快跑"式的微调,每一次微调只影响你想改的那一行。
边界:第 5 步只对代码化动效有效。视频生成模型产出的视频没法这样微调。你想改一处就得重新生成整段,重新生成会把之前好不容易调对的部分全部打乱。这就是为什么第 4 步要选代码化动效:第 5 步的微调能力依赖第 4 步的可编辑性。
06 Ship(发布)—— 静帧比对,确认通过再发
Francesco 在发布前渲染静帧,与参考视频和数据一一比对:在本人确认通过之前,任何内容都不会发出去。
应用场景:所有需要稳定质量输出的视频——商业解说、品牌发布、客户交付。核心判断:静帧比对是最低成本的质检手段。抽 3-5 张关键帧(开场、转场、收束),与第 1 步挑出的参考视频和第 2 步准备的数据逐项对比,有出入的地方要么改文案、要么改动效、要么改数据。
边界:临时性的视频(社交媒体随手发、个人 Vlog、灵感记录)不需要这一步。这类视频的容错率天然很高。但任何带承诺的发布(产品发布、培训资料、客户演示)都跳过这一步,等于把"质量"交给运气。
07 为什么大多数人会卡在第 4 步
Francesco 的结论很直接:大多数人直接跳到第 4 步(动效),然后纳闷为什么做出来和别人一模一样。真正的差异藏在第 1 步和第 5 步——先拆解别人做得好的地方,再以导演的方式微调,而不是一遍遍重抽。
这背后有一个更普遍的教训。AI 工具的默认工作流往往是「最高频路径」,但不是「出彩路径」。视频生成模型的市场定位就是「输入一段 prompt、输出一段视频」,这恰好对应大多数人跳过第 1-3 步的工作方式。要做出不一样的视频,必须刻意偏离这条默认路径,把第 1 步(参考)和第 5 步(导演式微调)这两件事做实。
今天就能跑的第一步:挑一段你真正喜欢的视频(不是行业里大家都在抄的那种),把它丢给 Claude,让它按 Francesco 的 6 步框架做一遍。先把"参考 + 数据 + 故事"这三件事做完,再考虑做动效。哪怕你最终只用 Claude 做一段 30 秒的短视频,先把前 3 步走完,视频的"为什么不一样"会立刻显形。
最后一条边界:本文 6 步框架全部按 Francesco 在 24 秒视频里的发言整理。每步的具体操作("挑一段视频""列数字""写一个核心观点""拆解为什么有效")按视频原话取,不外推视频之外的 Francesco 教程、其他 AI 视频工具或其他创作者的工作流。
原作者:Francesco(X @francescoinweb3);本文转写自 Francesco 的 24 秒 X 视频(2026-10 发布于 https://x.com/francescoinweb3/status/2110658198579335394/video/1?s=46),所有 6 步框架与原话均按视频原文取。