手里有 Cursor、Claude Code 这类 Agent 的人都遇到过同一件事:盯着它干活,效率翻倍;走开十分钟,回来就得收拾残局。所以问题从来不是模型够不够强,而是你敢不敢走开。
把这个问题回答得最彻底的,是 Lauren Tan,网名 @poteto,SpaceX AI 的 GrokBot 团队工程师,半年前加入 Cursor(后来 Cursor 并入了 SpaceX AI)。上个月,她向生产环境合入了 2,000 个 PR——标题幻灯片上就写着这行字。这场三十八分钟的演讲出自 Cursor Compile,全程只讲一件事:信任不是敢不敢的问题,是可以一层一层搭起来的工程。
这场演讲值得改写成一篇长文,因为它交付的不是感想,是三样可以直接拿走的东西:一套让 Agent 自己验证自己工作的做法(CLI 加 Feature Map)、一张五层信任谱系、一份反模式治理清单(园丁、铺路、先 lint 后清理),外加一个正在线上跑的自动复现 Bug 的实例。本文按视频把三十张截图逐张核过一遍,正文以画面为准,整理稿里走样的地方顺手订正了两处。
01 先纠正一个词:不是工厂,是米其林厨房
演讲的第一个纠正是用词。她不喜欢「软件工厂」这个说法——那会让人以为技术人是流水线上做重复劳动的。她更喜欢的比喻是米其林厨房:主厨、二厨、切配、洗碗工怎么排班,用什么设备、受过什么训练,厨师和洗碗工的比例是多少,这些加在一起决定了出品。写代码这件事更像烹饪,多少算一门手艺。
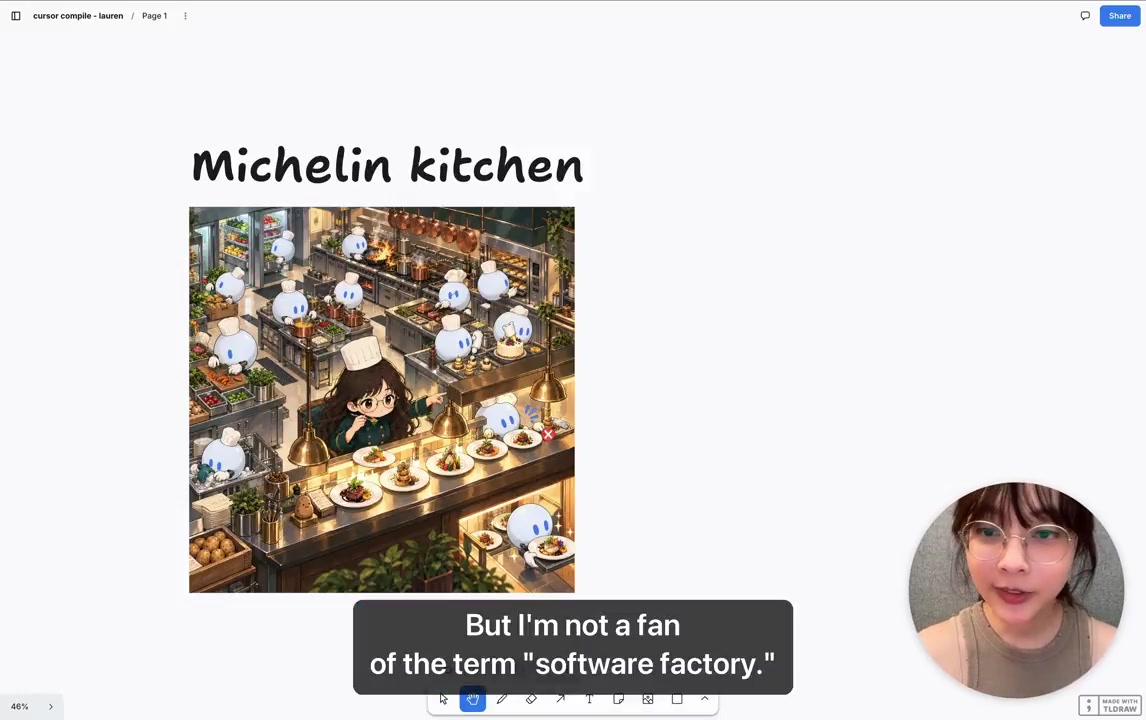
智能体进场之后,人的角色变了。用她的话说,智能体不再是只负责洗碗的那个角色了——但端出去的每一道菜,出品的责任仍然在你。厨房还是个危险的地方:看到厨师和洗碗工总在同一处绊倒,要立刻修掉,别等下一个人受伤。她对代码库的态度完全一样——要布置到连知识最少的 Agent 也不会在那里摔跤。
02 起点:一堵推不倒的 PR 之墙
她的起点是六个月前刚加入 Cursor:全新的代码库,几乎没有现成的 Agent 技能可用。当时 Cursor 正在重写新的 agent 窗口,旧窗口有严重的性能问题,她因为在 React 团队工作过被拉去帮忙——幻灯片角落里那句原话是「看起来挺合适」。
真正动手才发现流程有多原始:开着 Chrome DevTools 跑性能 trace、抓堆快照,全程手工;而 PR 像一堵墙一样源源涌入,没有任何办法知道性能是不是在悄悄回退。转折点是她想通了一件事:既然已经有 Agent 了,我为什么还坐在这里手工做?于是有了「验证技能」的思路——让 Agent 自己启动应用、自己抓 trace、自己读懂 trace、找到热点,再自己迭代把性能往上推。
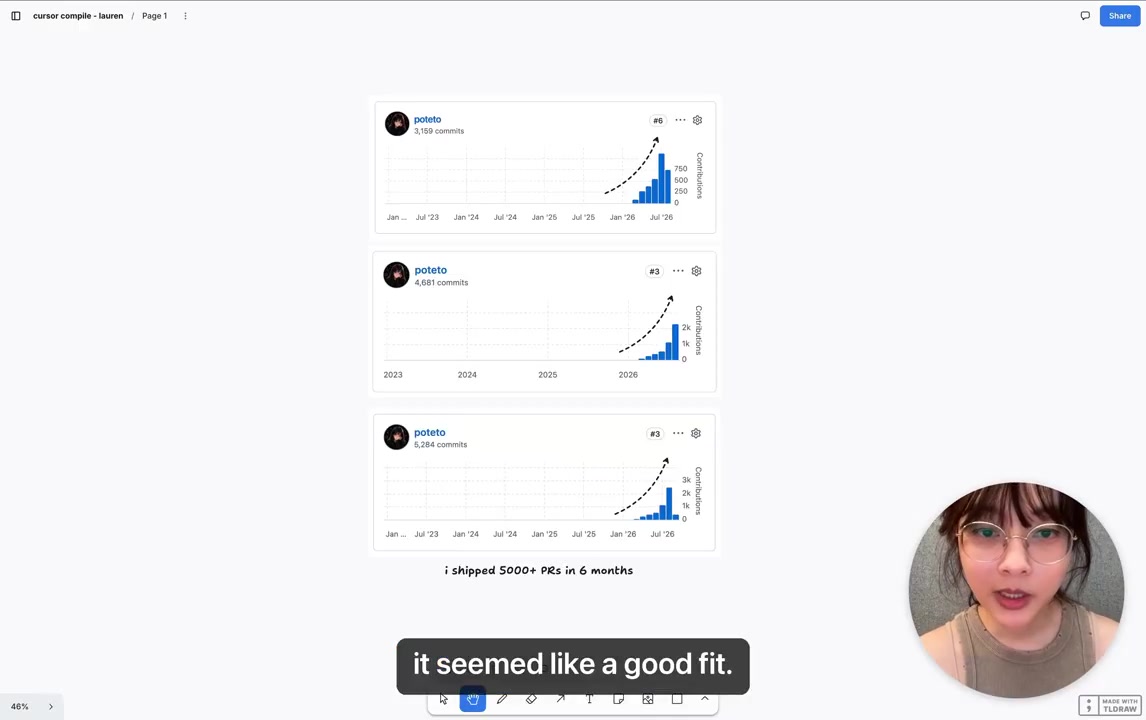
回头看这六个月,幻灯片上贴着她的贡献图,两张图的提交计数停在 4,681 和 5,284,配了一行字:六个月合入了 5,000 多个 PR。她强调自己从没把「一个月 2,000 个 PR」当成目标——所有技能、工具和代码改造做下来,最后都收敛到同一个词上,就是信任。
03 从 1 到 5 个 Agent,是最难的一段
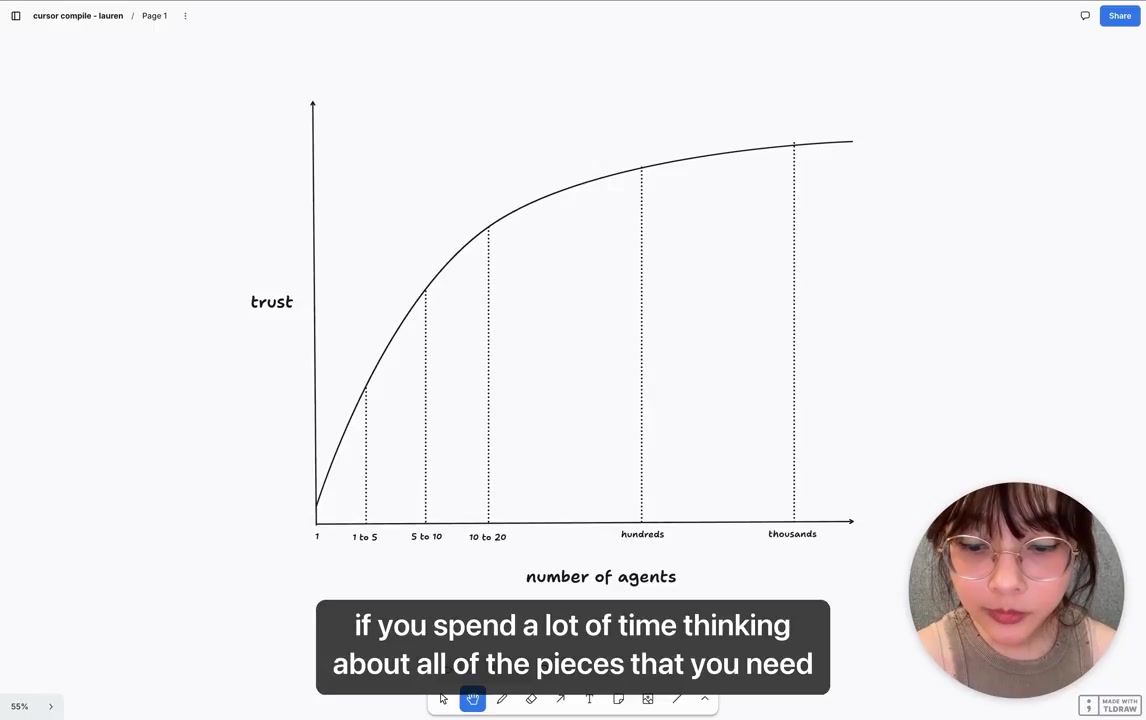
她画了一张图:横轴是同时在跑的 Agent 数量,从 1 到 5、5 到 10、10 到 20,一路到成百上千;纵轴是信任。大多数人卡在最左端:每一轮对话都要盯着,不断纠偏、不断介入,一走开 Agent 就做错事。她说这一段恰恰是最难跳出来的,因为怎么跳并不显而易见。
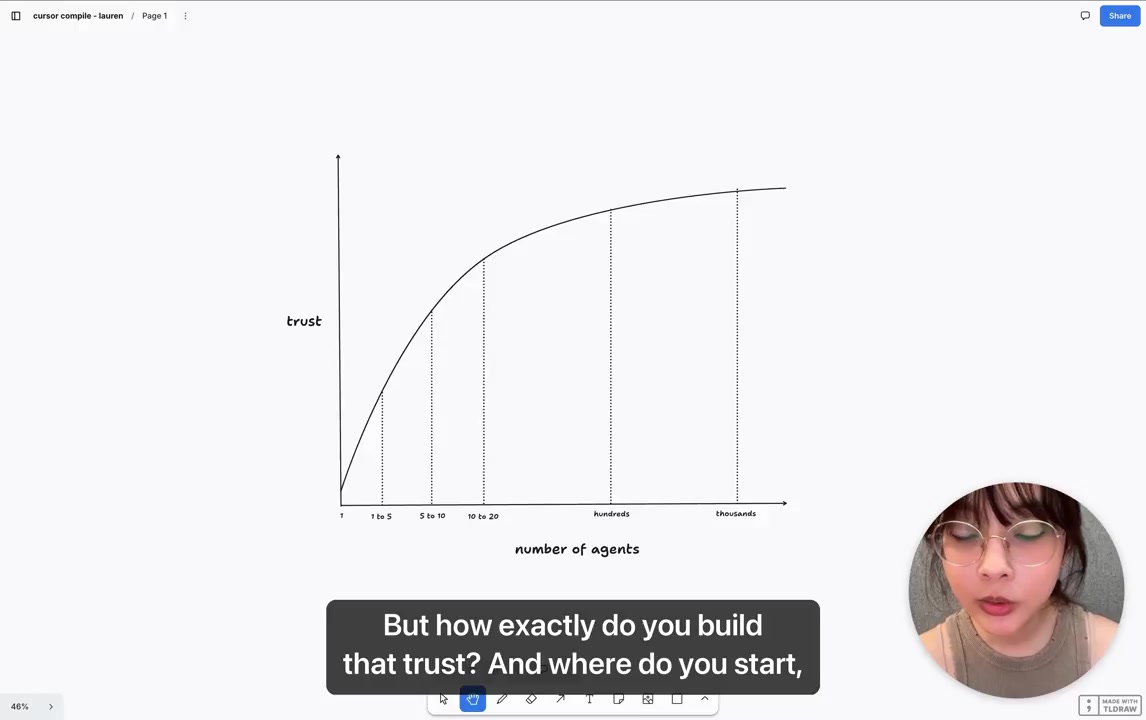
答案不是「换个更强的模型」。没有信任,却贸然把一百个子 Agent、云端 Agent 撒出去,换来的只会是一堆粗糙的 PR、大量回归和推到生产环境的 Bug——没有人会对此满意。瓶颈从来不在 Agent 数量,在你对它的产出有没有把握。
04 Control Glass:Feature Map 给语境,CLI 给控制
她在 Cursor 做的第一个技能叫 control glass:通过 Chrome DevTools 协议,教 Agent 运行应用并采集 trace。幻灯片把这个技能拆成两半,一句话概括:Feature Map 给语境,CLI 给控制,合起来是「Agent 能验证自己的工作」。
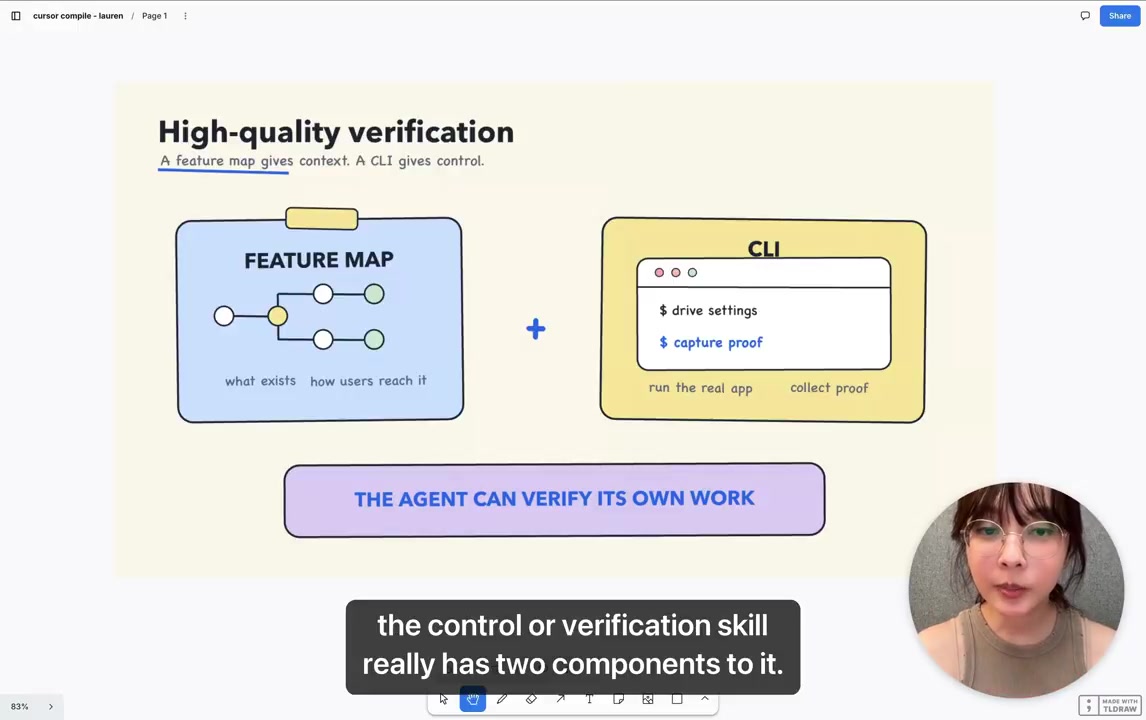
CLI 这一半,是放在技能目录里的可复用命令:让 Agent 可复现地启动真实应用、收集 trace,以及「代码能用、性能达标」的实证证据。她的反面提醒很具体:别让 Agent 每次现场生成脚本,不同会话生成的脚本差异很大;不如在技能目录里维护一个 CLI 让它每次调用同一个,然后持续投入把它打磨到覆盖各种用例、总能正确把应用跑起来。
Feature Map 这一半是她自创的概念,名字借鉴了 sitemap 的思路,起因是 Slack 里天天出现的场面:用户贴一张非常模糊的截图,后面跟三个问号。Agent 就算能运行应用,也完全猜不出对方想要什么。Feature Map 就是应用的物化记忆:有哪些功能、用户怎么到达(键盘快捷键还是点击哪个 DOM 元素)、每个功能是干什么的;它存在技能目录里,作为代码库的一部分,还有一套自动化持续维护它。两半合起来之后,Agent 既能可控地运行并追踪应用,又能听懂内外部用户的请求——这套控制与验证技能很快变成团队的关键基础设施。
05 验证只管正确性,质量得另想办法
但验证有边界。它主要回答正确性:结账按钮是不是真的走通了支付流程?这个能拿出实证证据。它管不了性能,也管不了代码质量。顺带一提,验证本身也分层次:低端是验证技能,高端是用 Lean、TLA+ 这类形式化方法证明业务不变量始终成立——那至今仍是开放难题;她自己的判断是,光靠验证技能也足以走得很远。所以下一张幻灯片给了三条并行的路:验证保正确性;用高质量技能教 Agent 像真正的软件工程师那样工作;以及重构、改写架构让它对 Agent 友好——她还补了一对注脚,绿地与棕地。
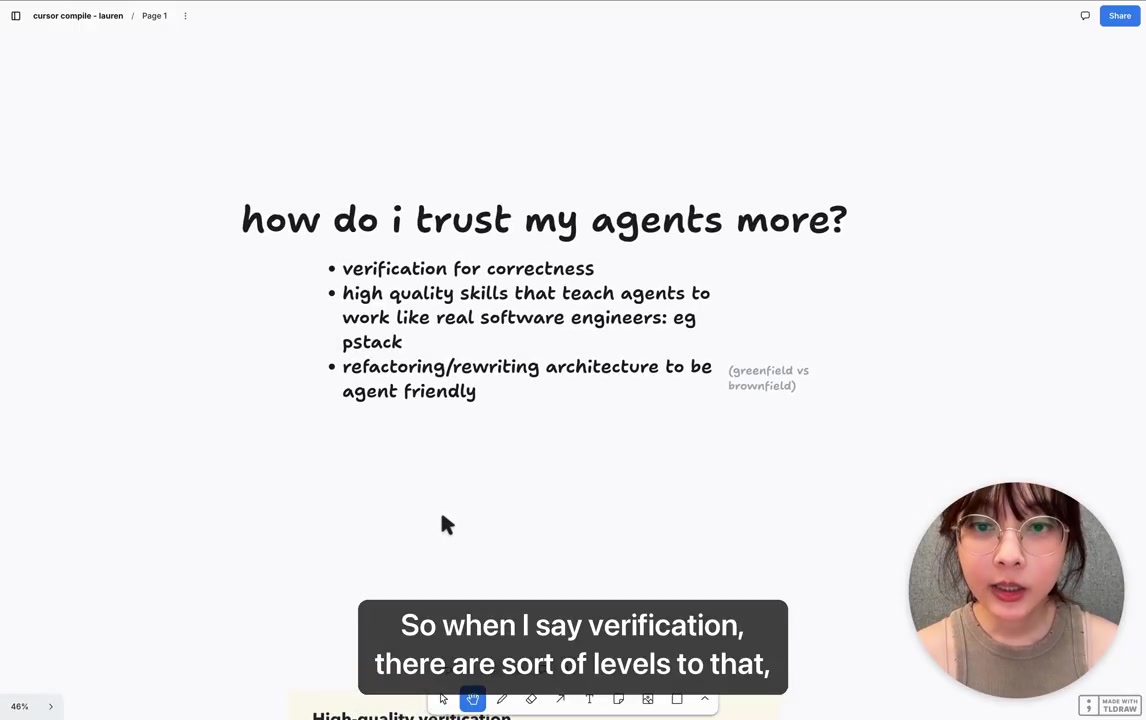
她做过一个插件叫 pstack,把多年工程实践里真正在用的工作流——调试、功能开发、原型设计——打包成一整套技能和剧本,让 Agent 按你期望的方式写代码。这也是团队里资深工程师能真正出力的地方:搭一个团队共享的技能库,让自己的 Agent 变聪明。技能与验证合在一起,Agent 既能验证正确性,又能保住质量,还能顺手采到真实的性能指标、统计和遥测数据。
06 五层信任谱系:代码库是最好的记忆
整场演讲如果只带走一张幻灯片,她会选那张五层清单——每当你在纠正你的 Agent,就回到这五层:一,代码库;二,静态分析(lint、编译器、CI);三,rules 和 Bugbot;四,skills;五,「风格指南」。
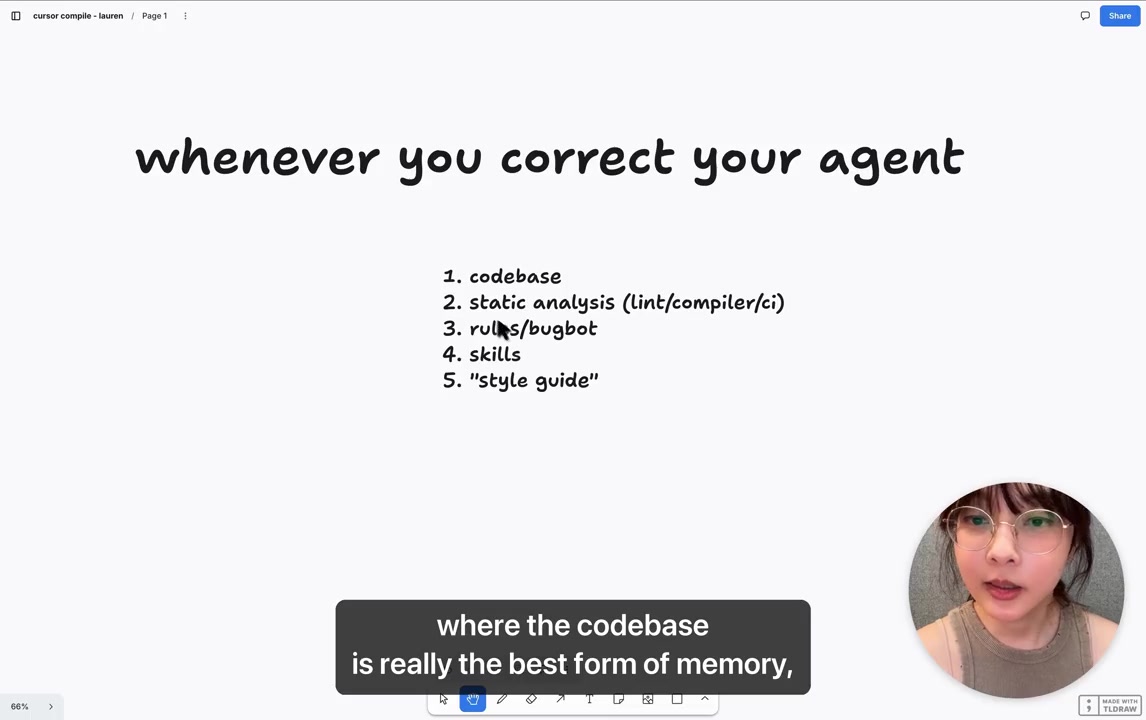
第一层为什么是代码库本身?因为代码库是 Agent 最好的记忆:模型天然倾向于复用上下文窗口里已有的内容,Agent 不会在每个 PR 里顺手重构,它只会观察现有代码、顺着既有结构往外长。所以代码结构直接决定它的行为。第二层静态分析是硬约束;Agent 反复犯的同一类错,可以沉淀成一条 lint 规则,更好的做法是直接重构到那个错误在结构上就不可能发生。第三、四层是软性引导,Agent 通常会读、会照做,但也可能忘。第五层风格指南基本只能靠人在 code review 里把关——而在这个 PR 量级下逐行 review 几乎不可能落地。她的建议是:风格指南和人工 review 只当起点,用它发现现在还缺什么;真正的投入砸在前四层。
07 Dune:Agent 爱走捷径,那就把捷径修成正路
后半场讲的是把这套理念做成框架。GrokBot 团队搭了一个叫 Dune 的客户端框架,灵感正来自她在 Cursor 智能体窗口里看到的那些性能问题。核心原则一句话:Agent 天生爱走捷径,那就把框架设计成捷径恰好就是正确路径。
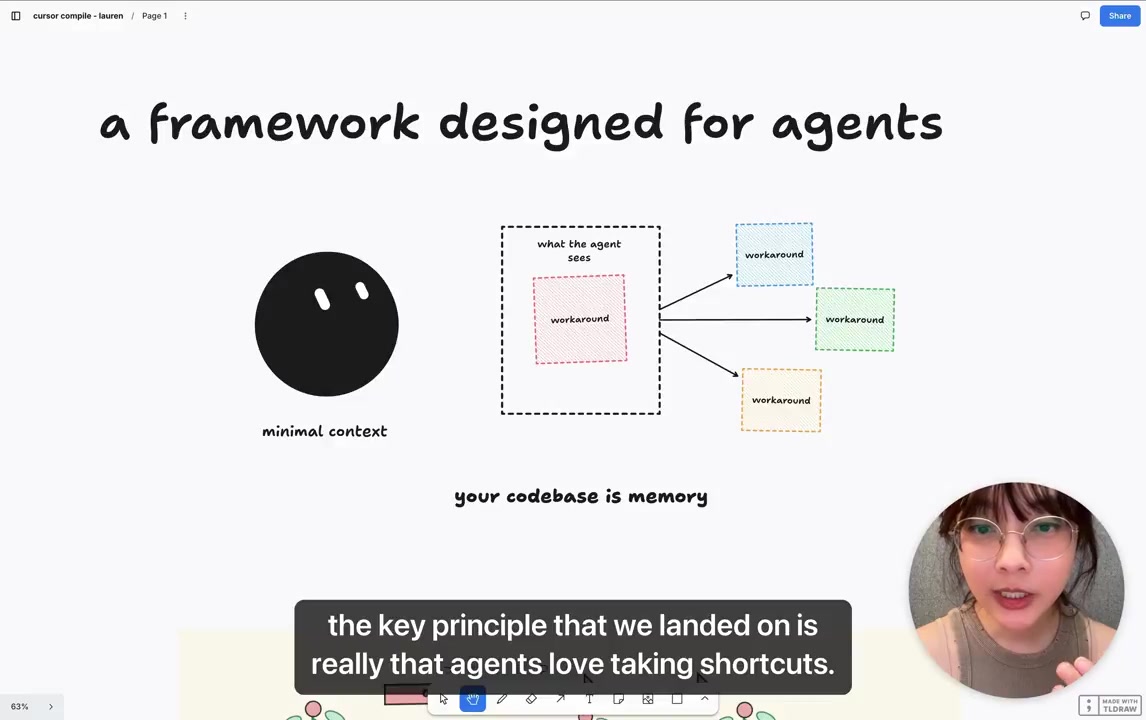
这样的代码库对人类反而显得受限,这不能做、那不能碰;但对上下文很少的 Agent,它是完美环境。她给的理由值得抄下来:以后往代码库提交东西的未必都是工程师,设计师、产品经理、甚至 CEO 都会进来——所以要设计成忙碌的、没什么上下文的人操作 Agent,默认也能得到好结果。幻灯片画的是 Agent 眼中的世界:一小块极简上下文,加一座被当作记忆的代码库。
08 把边界画进目录树
Dune 具体到什么程度?一张幻灯片写着,五个名词组织整个应用:Client、Feature、Entrypoint、Host、Transcript card,每个名词在目录树里只有一个位置、在运行时只做一件事。更狠的是把进程边界也画进目录树:renderer/ 里只有 React 视图和链接,Client 持有本地副本和命令,Electron 主进程管窗口和系统能力,跨进程的类型放进 shared/。一张文件夹结构就告诉 Agent:这段代码跑在哪个进程、哪些 import 是合法的。
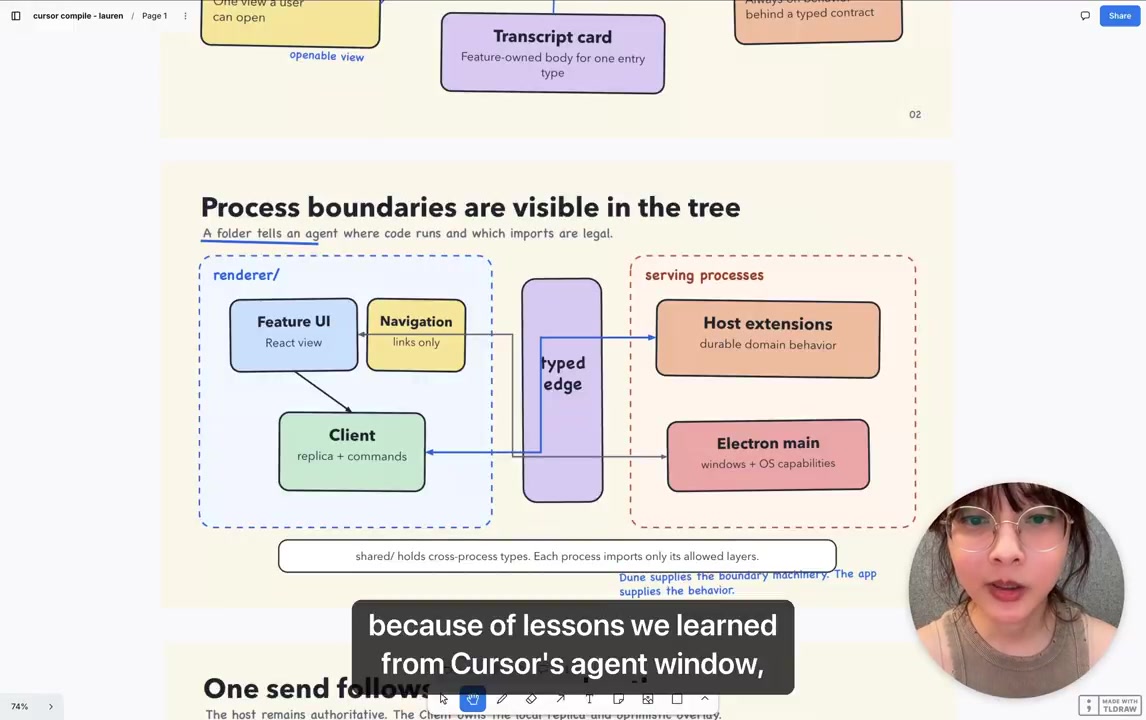
这条边界的出处正是 Cursor 的教训:曾有代码被错误地导入渲染线程,直接造成 UI 卡顿。渲染线程必须没有长任务——60 帧意味着每帧 16 毫秒,120 帧是 8 毫秒,超时就要拆分。Dune 用 import 关系和依赖图把这些边界做成机器强制,幻灯片原话是「Dune 提供边界机器,应用提供行为」。
09 竖切一片:一个功能的完整落点
另一张幻灯片把「一个功能怎么落」直接写成了文件清单:features/
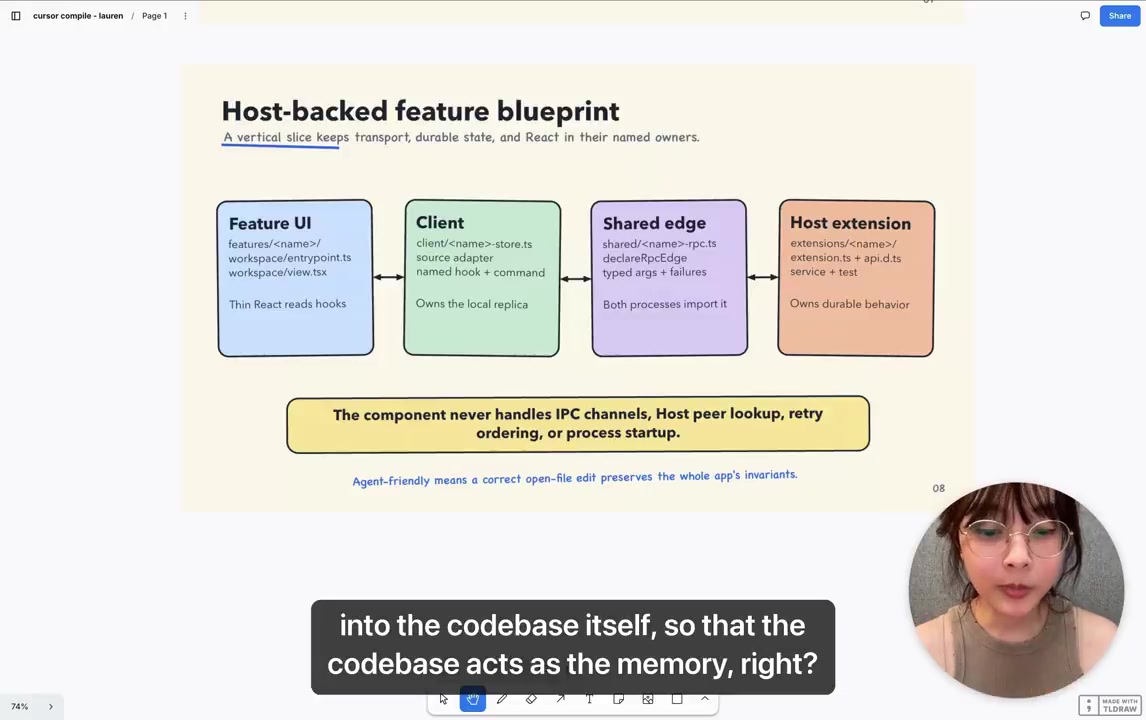
这张图底下压着一句定义,值得原样抄录:所谓对 Agent 友好,是指一次正确的打开文件编辑,能保住整个应用的不变量。她自己点破了关键:重点不在 Dune,而在于把团队里最好那些工程师脑子里的隐性知识——过去靠 code review 和风格指南口口相传的东西——提取出来,编码进框架和代码库本身,让代码库自己当记忆。
10 反模式会传染,注释是第一个
反过来同样成立:代码库里已有的反模式,Agent 会原样复制。幻灯片画得直白:左边一个 workaround,右边写着「THE PATTERN」,中间连着三个 copy——每复制一次,下一次复制就更可能发生。一个带解释注释的小变通,几天到几周内就会被复制到全库,变成事实上的标准模式。
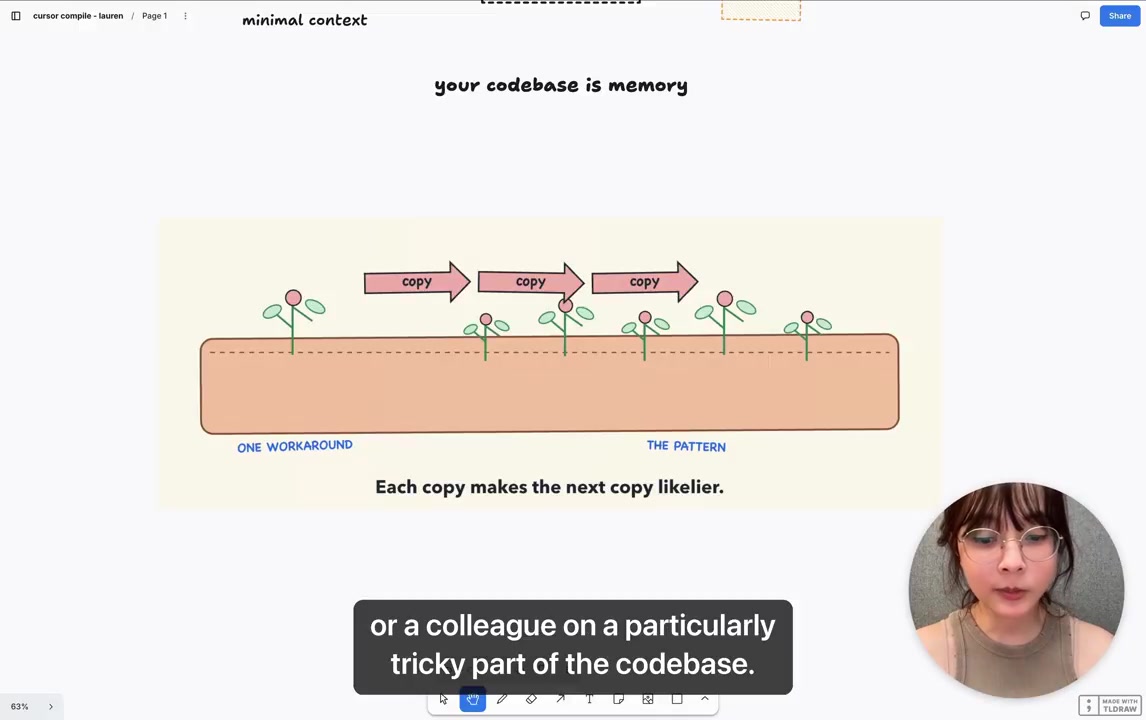
最典型的例子出人意料:注释。听起来无害,人写注释再正常不过。但她在 Cursor 的代码库里观察到,Agent 实际是在用注释给自己的代码辩护——借注释回避根本解决,贴一片创可贴了事。所以做 Dune 的时候,她们干脆禁止 Agent 在代码里留注释,就为防这个模式扩散。她另一个类比是花园:代码库像花园,看似无害的变通会被 Agent 无限复制,最后长成一个技术债和性能问题缠身、没人维护得了的「氛围编程」代码库。
11 园丁、铺路石、先 lint 后清理
治理方式她也给了清单。每个团队需要一个「园丁」:专门盯着反模式,在它刚冒头、还没像杂草害虫一样蔓延开之前掐掉。落到 Dune 是三条原则:删掉既有技术债;只保留一条约定俗成的 paved path——大多数常见写法只有一种规范做法,Agent 不用猜,代码库、CI、lint 里都有足够引导;看到技术债先写一条 lint 规则止住增长,之后再慢慢清,不必立刻修完。
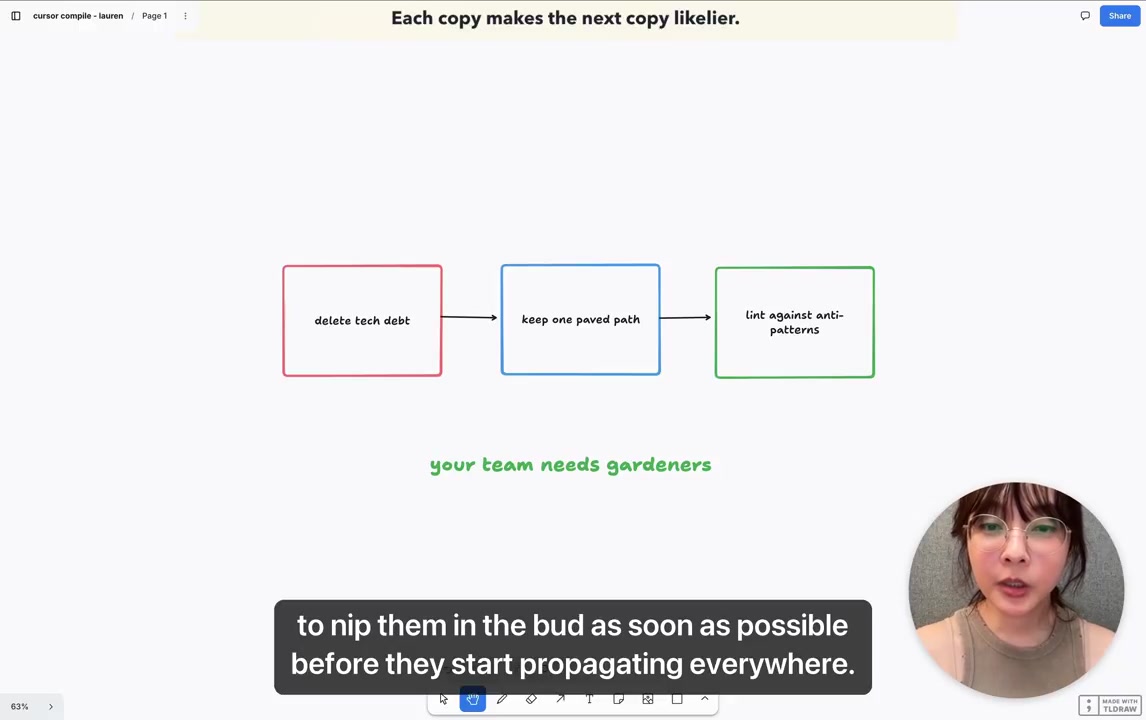
这三条背后是一个统一的心态:让代码库始终处于 Agent 随便复制也无所谓的状态。一方面主动防范反模式扩散,另一方面让 Agent 持续清理技术债,两边一起转。
12 外循环:告警进来,云端 Agent 出动
这些都到位之后,厨房才算成型。幻灯片把自动化分成两层:个人自动化,是 line cook agent、GrokBot(她标了个 new)、云端 Agent;团队自动化,是 factory agent,靠 automations 和 Agents SDK 串起来。
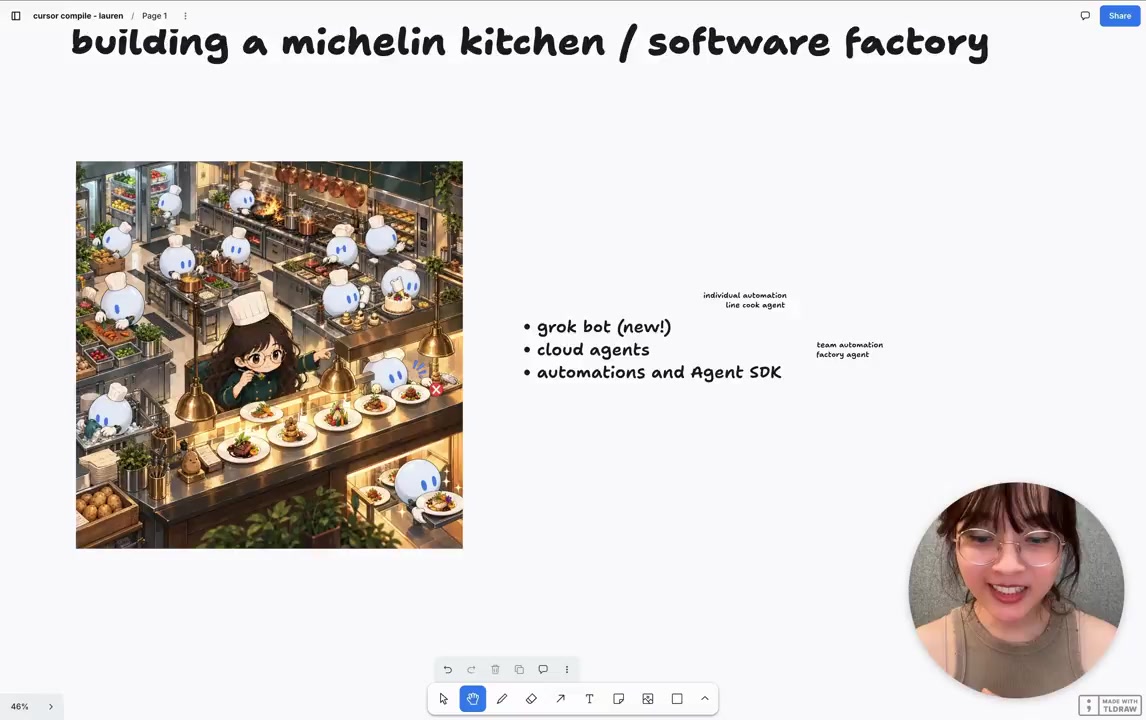
GrokBot 的长处在「外循环」:接上 Slack、Datadog、Sentry、PlanetScale 这些连接器,把分散的信息聚合起来再决策。有人管这叫「公司大脑」,她倒觉得不需要那么复杂——Agent 本来就擅长用工具,把工具接进 GrokBot、让它自动拉起云端 Agent 就够了。GrokBot 的 routines 可以订阅 Slack 线程和 Sentry 告警自动触发流程;Cursor 侧的 automations 和 SDK 还能再挂复用同一套基础设施的 Bot,去承担复杂得多的任务。把这些组合起来,不需要多重的基建,能力是持续叠加的。
13 实战:一条被自动复现的 Bug 报告
她给了一个正在线上跑的实例,是一张 Slack 截图:值班频道里有人报了个 Bug——切换面板焦点时,Apps 侧边栏总会自己弹出来,明明手动关掉了还是会弹;发的人还附了录屏。
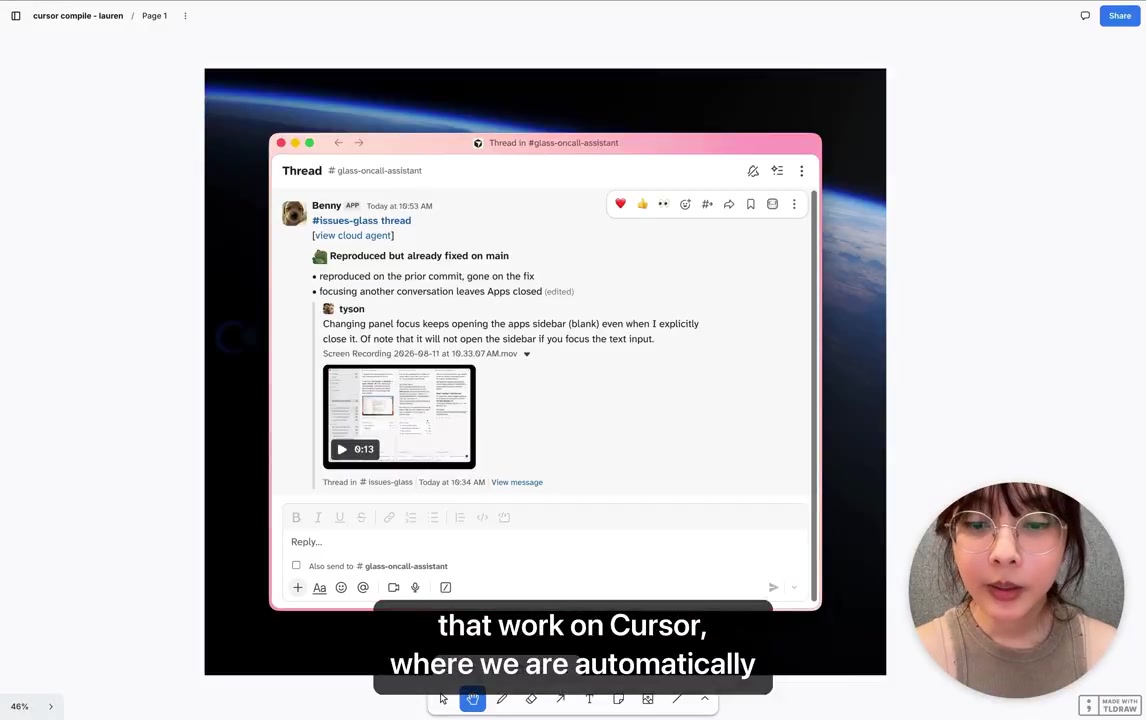
接下来不是人去复现。值班助手——一个云端 Agent——自动接手:在出问题的前一个提交上复现成功,再到修复提交上验证消失,然后回到线程里留下结论——「已复现,但主干上已经修掉了」,旁边还挂着一个可点的「查看云端 Agent」。一条报修从进来到关掉,没占用任何工程师的时间。她说这类自动复现 Bug 报告、自动开 PR 的流程,正在持续为整个团队叠加价值,所有环节都在复利。
14 收在一张图:每次纠正 Agent,回到五层
收尾回到开头那张信任曲线,只是横轴这次一直画到了「成千」。她的建议是一个自检动作:每当发现自己在纠正、审问 Agent,就回到那五层里找——当前最有效的着力点是哪一层。投入的顺序她也给了:先用代码库、架构和数据结构,让一整类错误根本不可能发生;再上静态分析;然后叠加 rules、Bugbot 和 skills;同时持续打磨代码质量和技能。
这些都做完,Agent 就可以放开自己跑了。她自己已经在 Grok 代码库上花了大量时间走这条路,成效显著——顺带承认这算不上什么秘诀,本质上还是大量的艰苦工作。联系方式在 X 上:poteto,中间带个 e。
15 编者按:从哪一步开始,边界在哪
如果只带走一个动作:翻出你最近三次忍不住接管 Agent 的地方,对着五层清单各问一句——这个问题能不能落到某一层上?能重构掉的别写进 rules,能写成 lint 的别靠人盯着,能交给验证技能的别用眼睛看。三个坑各对应一层,修一次管一类。
三条边界也要说清楚。第一,所有数字——2,000 个 PR、5,000 多个、16 与 8 毫秒——都是演讲者自述与幻灯片原文;Dune、control glass、pstack 都是她的团队内部设施,没有公开实现可供复现。第二,「禁止注释」是她们代码库的激进选择,前提是 paved path 已经足够完善;直接照搬到一个约束不足的库,只会让 Agent 更迷茫。第三,这套方法论的地基是每月成百上千个 PR 的量级——如果你的库一个月只有十几个 PR,人工 review 仍然是最便宜的那层信任,不必为了五层谱系推翻现有流程。